Глубокие исследования без границ: выбираем свою LLM и управляем стратегией поиска
Когда мы говорим о “глубоких исследованиях”, чаще всего имеем в виду сервисы, которые сами планируют поиск, бродят по источникам, собирают цитаты и выдают аккуратный отчет. Это удобно, но почти всегда жестко привязано к одной стратегии и одному семейству моделей. Авторы Universal Deep Research (UDR) предлагают новый подход: дать пользователю выбрать любую LLM и самому задать стратегию исследования — без обучения моделей и сложной настройки. По сути, это обертка над LLM плюс компилятор стратегий из естественного языка в исполняемый код, который можно проверять, повторять и изменять.
Почему так важно отделить модель от стратегии
Сегодняшние инструменты deep research — Gemini, Perplexity, OpenAI Deep Research, Grok DeepSearch — хорошо ищут и аккуратно формируют отчет, но прячут ключевые рычаги. Пользователь почти не влияет на приоритеты источников, кросс‑валидацию, контроль стоимости вызовов, не может подменить “мозги” системы на свою любимую LLM, а главное — не может описать собственную, предметно‑специфичную тактику. Это особенно бьет по тем, кто работает в финансах, праве, здравоохранении и других высокоценных доменах, где цена ошибки велика, а требования к проверке источников жесткие.
UDR пытается закрыть три пробела сразу:
- гибкий контроль источников, проверок и бюджета;
- возможность задавать специализированные стратегии под домен;
- свободная компоновка: любую стратегию можно запускать на любой LLM.
Как это устроено изнутри
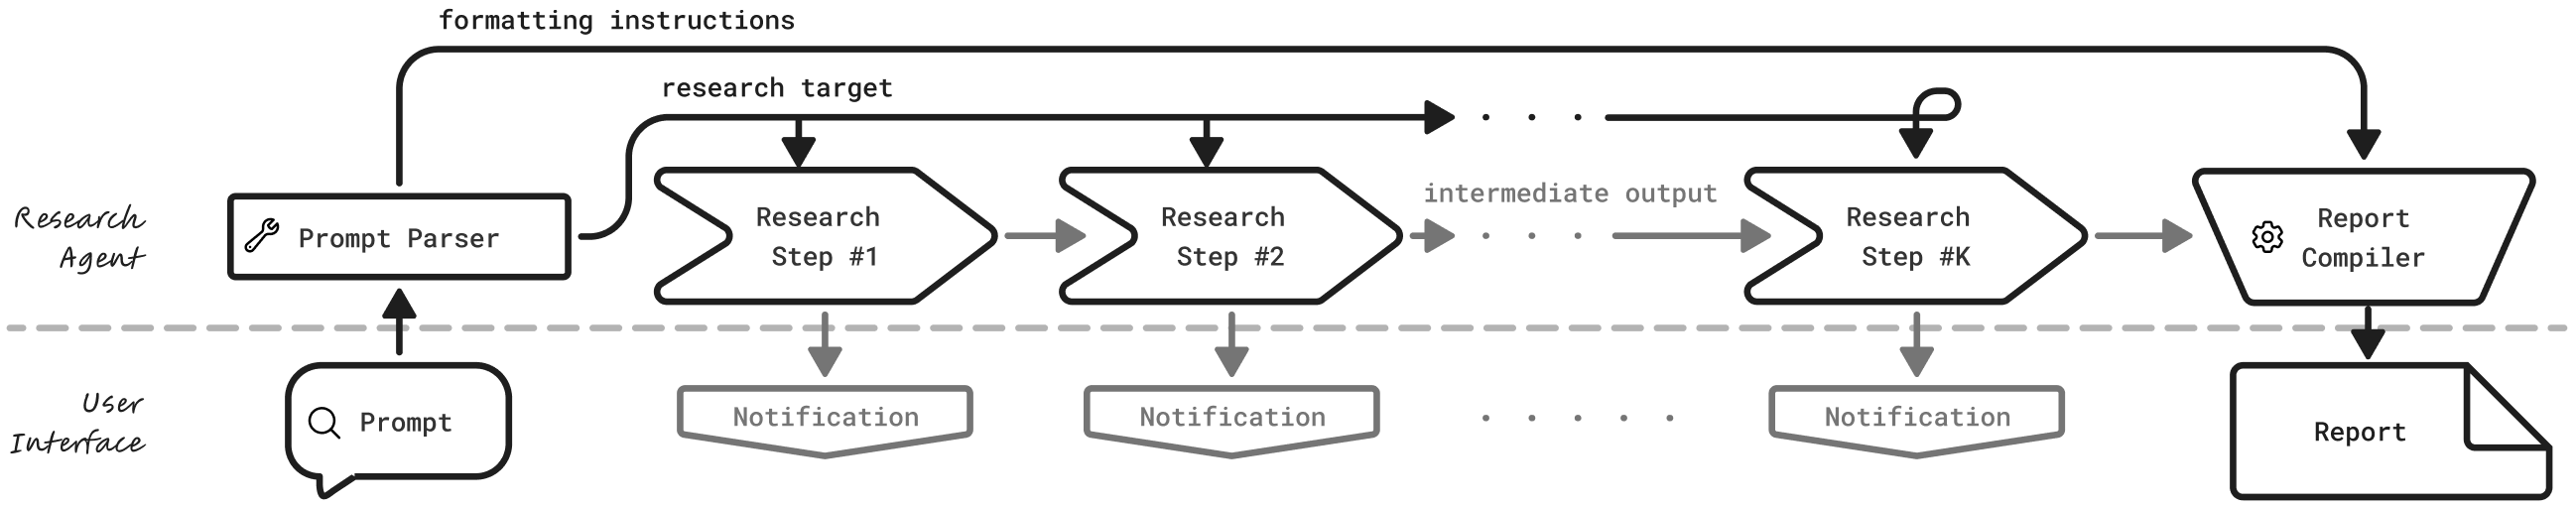
Система работает в две фазы. Сначала стратегия, описанная простым списком шагов (на человеческом языке), превращается LLM в единый исполняемый код с понятным управлением и ограниченным набором инструментов (поиск, ранжирование, извлечение и т. п.). На этом этапе от модели требуют строгого соответствия: каждый кусок кода снабжен комментарием, какой пункт стратегии он реализует. Это сильно снижает риск, что LLM “срежет углы”, пропустит шаг или добавит лишние ограничения.
Далее код исполняется в изолированной “песочнице” с детерминированными вызовами инструментов. Все промежуточные данные живут в именованных переменных состояния, а не в растущем контексте чата — поэтому хватает даже небольшого окна (в экспериментах — 8k). Рассуждения LLM используются как утилиты: суммаризация, извлечение фактов, ранжирование. Оркестрация — это уже обычный код на CPU, а не скрытая “магия” внутри промта. Прогресс пользователь видит через поток уведомлений: стратегия сама решает, когда и что показывать.

Что дает такой подход
- Надежность. Цельный код оказался стабильнее, чем длинные промты с рассуждениями или пошаговая генерация фрагментов. Меньше каскадных сбоев, проще аудит.
- Эффективность. Разделение ролей снижает стоимость: LLM вызывается только там, где нужна ее интеллектуальная работа, а не для всего процесса.
- Прозрачность. Уведомления, переменные состояния и воспроизводимый финальный отчет делают путь к результату прослеживаемым.
- Безопасность. Исполнение в изоляции ограничивает риски от пользовательского кода — важный момент для корпораций.
Авторы показывают три семейства стратегий: минимальную (быстрый проход), экспансивную (широкое покрытие тем), и интенсивную (несколько итераций с переосмыслением поисковых фраз). Каждую можно править под задачи: от проверки гипотез в R&D до юридической проверки документов. Важно, что UDR не навязывает свою “агентность”: если в стратегии не задано свободное рассуждение, система не будет импровизировать.
Интерфейс для экспериментов
Поверх ядра есть простой UI: ввод промта, выбор и редактирование стратегии, поток уведомлений, просмотр отчета. Можно остановить исследование и сгенерировать промежуточный результат.

В демонстрациях стратегия минимального уровня на Llama 3.3 70B уверенно выдавала аккуратные отчеты по культурным и историческим запросам, по датам и новостным дням, а также по биографиям с требованиями к структуре и ссылкам. Важный момент — следование правилу “только из прочитанного в контексте”, что дисциплинирует модель и снижает риск домыслов.

Почему это важно
UDR аккуратно разводит модели и агентную логику. Это открывает двери к новым проверенным стратегиям для массовых сценариев. Производители LLM могут конкурировать качеством рассуждений, а разработчики — качеством стратегий, не мешая друг другу. Для организаций это путь к контролируемым, воспроизводимым исследованиям с четким управлением стоимостью и рисками.
Читайте также
 Как мозг предсказывает следующее слово и при чем тут ИИ
 Как обучение с подкреплением перестраивает мышление LLM
 Агенты без скриптов: что происходит, когда ИИ сталкивается с реальностью
 Репозитории на автопилоте: как ИИ сам поднимает окружение и запускает код
 Как ИИ начинает понимать чёрный юмор
 Как оживить научные статьи: превращаем исследования в интерактивных ИИ-ассистентов
 Что скрыто за характером LLM: читаем поведенческие отпечатки
 Почему LLM врут с умным видом
 ИИ как соавтор: как агенты меняют науку прямо сейчас
 Vision Language World Model: язык как картина мира
 Почему Text-to-SQL до сих пор ломается и как это исправить
 Увидел-кликнул-победил: как UItron управляет компьютером по-человечески
 Аккуратные дипфейки: как невидимые подмены лиц рушат доверие к видео
 Как Avengers‑Pro превращает зоопарк LLM в супер-роутер за счёт одного ползунка
 Как построить мультиагентную систему, которая реально работает без магии и костылей
 Как дообучать LLM на лету с помощью памяти вместо файнтюнинга
 Нажал — и мир двинулся: Matrix-Game 2.0 делает видео интерактивным в реальном времени
 OmniTry: виртуальная примерка одежды и аксессуаров без масок — система сама найдёт, куда «надеть»
 Покажи — и робот поймёт: как Embodied‑R1 сокращает разрыв между «вижу» и «делаю»
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram