Как обучение с подкреплением перестраивает мышление LLM
Задачи на рассуждение — больное место многих ИИ-систем, даже если у них хорошие фактические знания. Новая работа показывает, что усиление через RL (Reinforcement Learning, обучение с подкреплением) не просто повышает точность, а перестраивает внутреннюю логику модели: появляется иерархия от низкоуровневого исполнения до высокоуровневого планирования. Отсюда понятно, почему мы видим те самые aha-моменты. А главное — становится ясно, почему привычные алгоритмы распределяют усилия не туда и как это исправить.
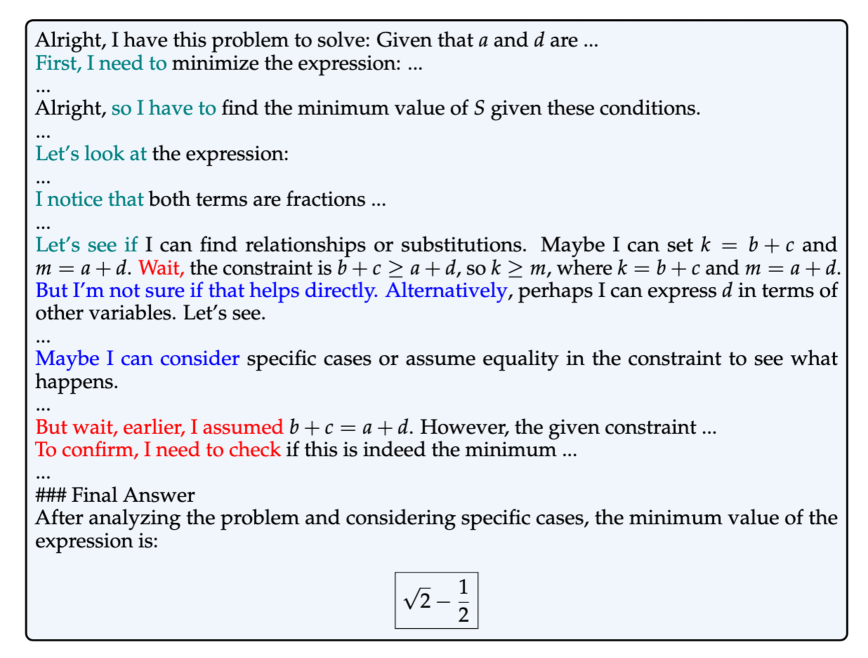
Как отличить планирование от исполнения
Авторы исследования вводят простой, но полезный прокси: Strategic Grams (SG) — устойчивые 3–5-граммы, которые управляют ходом решения. Это шаблоны вроде “let’s try”, “we can use”, “but the problem mentions” и т. п. Токены, входящие в такие n-граммы, считаются планирующими; остальные — для исполнения: считать, подставлять, применять формулы. Набор SG собирают из успешных решений и аннотируют наполовину автоматически, наполовину вручную. Получается функциональная раскладка по ролям, не завязанная на поверхностные признаки.
Что происходит во время обучения
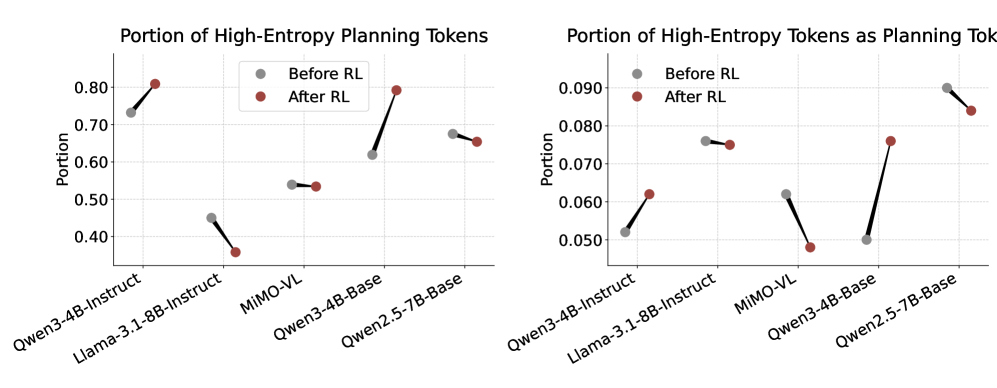
Сначала модель доводит до автоматизма операции исполнения: резко падает перплексия и энтропия на этих токенах — уверенность растет, ошибок меньше. Это быстрый этап, особенно для уже сильных LLM, где низы изначально неплохо отлажены.
Затем фронт обучения смещается в стратегию: растет разнообразие стратегических ходов, цепочки рассуждений становятся длиннее и упорядоченнее, точность продолжает расти — уже за счет планирования. Здесь и рождаются aha-моменты: модель находит новые приемы, осваивает разветвления, бэктрекинг и рефлексию.

Почему обычные метрики путают следы
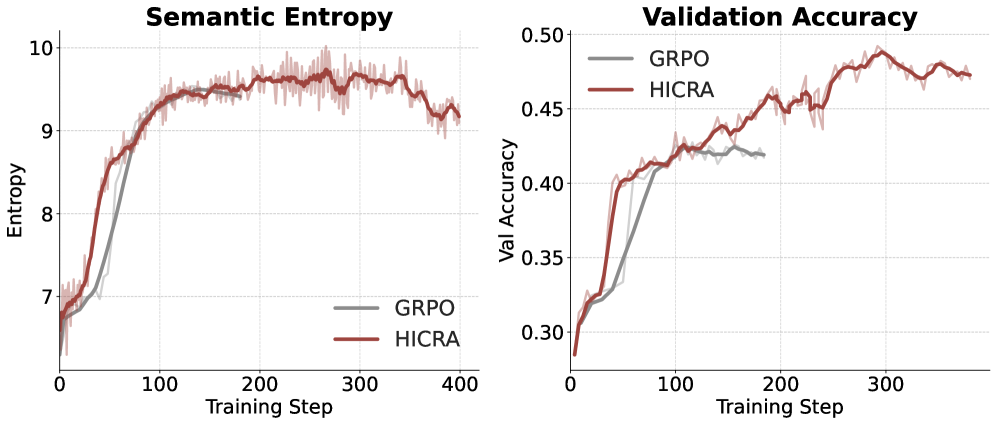
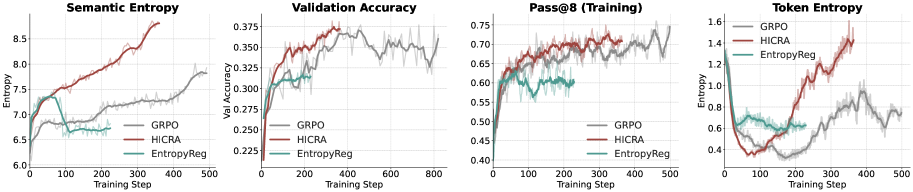
Энтропия токенов падает, потому что основную массу текста составляют токены исполнения, где уверенность после RL возрастает. Можно решить, что исследование стратегий угасает — и ошибиться. Куда точнее смотреть на семантическую энтропию по стратегическим n-граммам: она растет, когда модель расширяет репертуар планов, и лучше коррелирует с итоговой точностью.
Если бутылочное горлышко — стратегия, не стоит равномерно раздавать градиент по всем токенам, как это делает метод GRPO. Предлагается HICRA (HIerarchy-Aware Credit Assignment) — надстройка над GRPO, которая усиливает позитивный кредит и смягчает штраф именно на планирующих токенах. Формально это масштабирование преимущества на стратегических позициях с коэффициентом α=0.2. Политика сдвигается в подпространство стратегий, растет шанс открыть удачные планы и закрепить их.
Что показали эксперименты
Тестировали на Qwen2.5-7B, Qwen3-4B, Llama‑3.1‑8B и MiMO‑VL‑7B, от базовых до instruct-вариантов; в бенчмарках — AIME24/25, Math500, AMC23, Minerva, Olympiad и др. Картина повторяется: HICRA стабильно превосходит GRPO.
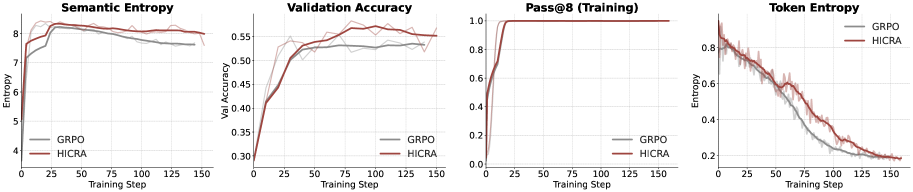
На Qwen3‑4B‑Instruct приросты заметны даже при сильной базе: AIME24 с 63.1 до 65.9, AIME25 — с 58.8 до 62.1, AMC23 — с 76.8 до 82.5, Olympiad — с 55.6 до 59.7. На Qwen3‑4B‑Base щедрые добавки на Math500: с 83 до 89. На Qwen2.5‑7B‑Base HICRA выигрывает у GRPO на всех задачах, особенно на AMC23: плюс 8.4 пункта. В мультимодальной настройке метрика Pass@K быстро насыщается, но семантическая энтропия продолжает отличать методы — и HICRA снова впереди.
На что именно влияет RL
Разметка ошибок показывает: в ходе RL быстрее всего исчезают стратегические промахи, а не процедурные. И это логично: неверный план обнуляет идеальное исполнение. Значит, правильное целеполагание должно подталкивать именно к поиску и закреплению стратегий.

Где метод буксует и что дальше
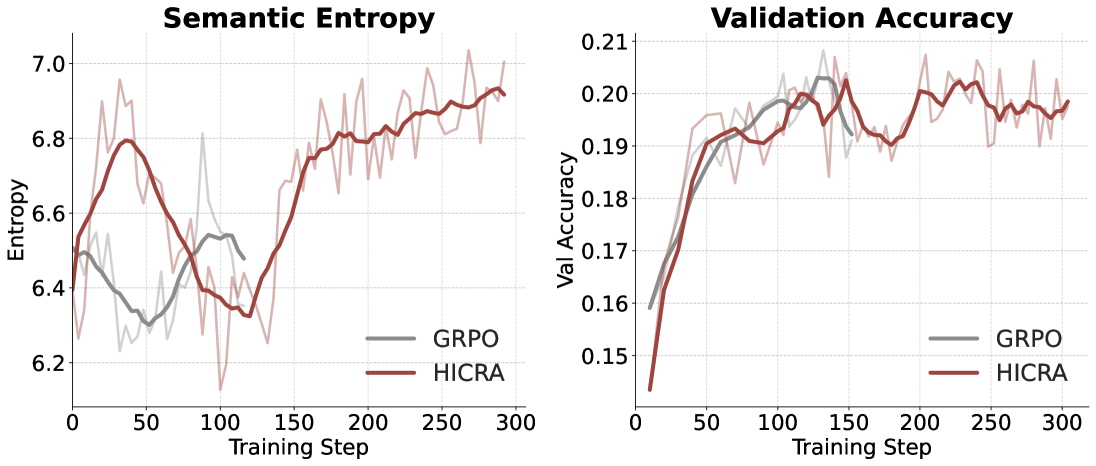
HICRA требует базовой надежности исполнения. На Llama‑3.1‑Instruct форсирование стратегии без прочного низового навыка ведет к нестабильности и не обгоняет GRPO. Вывод простой: нужен адаптивный режим, который понимает текущее узкое место — сначала укрепляем процедуры, потом усиливаем планирование.
Почему это важно
Идея иерархии и распределение по ролям переносится не только на математику. Код, научные рассуждения, длинное планирование текста, мультиагентная система с распределением функций — всюду, где стратегия и исполнение различимы, полезно усиливать именно стратегические токены и измерять прогресс через семантическую энтропию. Это делает обучение более предсказуемым и экономит попытки.
Читайте также
 Как мозг предсказывает следующее слово и при чем тут ИИ
 Агенты без скриптов: что происходит, когда ИИ сталкивается с реальностью
 Репозитории на автопилоте: как ИИ сам поднимает окружение и запускает код
 Как ИИ начинает понимать чёрный юмор
 Как оживить научные статьи: превращаем исследования в интерактивных ИИ-ассистентов
 Что скрыто за характером LLM: читаем поведенческие отпечатки
 Почему LLM врут с умным видом
 Глубокие исследования без границ: выбираем свою LLM и управляем стратегией поиска
 ИИ как соавтор: как агенты меняют науку прямо сейчас
 Vision Language World Model: язык как картина мира
 Почему Text-to-SQL до сих пор ломается и как это исправить
 Увидел-кликнул-победил: как UItron управляет компьютером по-человечески
 Аккуратные дипфейки: как невидимые подмены лиц рушат доверие к видео
 Как Avengers‑Pro превращает зоопарк LLM в супер-роутер за счёт одного ползунка
 Как построить мультиагентную систему, которая реально работает без магии и костылей
 Как дообучать LLM на лету с помощью памяти вместо файнтюнинга
 Нажал — и мир двинулся: Matrix-Game 2.0 делает видео интерактивным в реальном времени
 OmniTry: виртуальная примерка одежды и аксессуаров без масок — система сама найдёт, куда «надеть»
 Покажи — и робот поймёт: как Embodied‑R1 сокращает разрыв между «вижу» и «делаю»
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram