ИИ-ученый, который открывает законы природы без участия человека

В научных данных часто скрыты простые законы — уравнения, которые объясняют зависимость между величинами. Но найти их непросто: пространство формул огромное, данные бывают шумными, а перебор вариантов быстро захлёбывается. Символическая регрессия как раз и пытается восстановить такую компактную формулу. Многие подходы или перебирают деревья решений, или учат нейросети предсказывать готовые формулы. В обоих случаях LLM обычно лишь подсказывает идеи, а всю логику поиска жёстко задаёт человек.
Авторы SR‑Scientist предлагают иной взгляд: пусть LLM станет автономным учёным. Агент сам анализирует данные, пишет и запускает код, строит и проверяет уравнения, оптимизирует константы и шаг за шагом улучшает гипотезы, опираясь на экспериментальную обратную связь. Вся работа — как у настойчивого исследователя, только в машинном темпе.
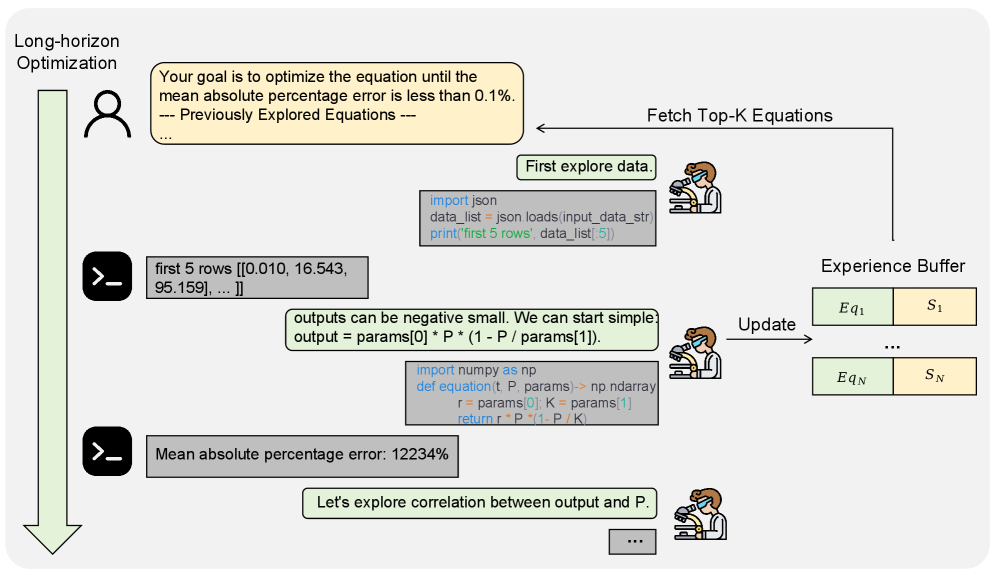
Как это устроено изнутри.
Агент действует в стиле ReAct: на каждом шаге рассуждает, вызывает инструмент, смотрит на результат и решает, что делать дальше. Инструментов два. Первый — аналитик данных: с помощью кода смотрит статистики и делает выборки. Второй — оценщик уравнений: принимает “скелет” формулы, численно подбирает константы и возвращает метрики. Это избавляет от бесконечного велосипеда в коде и даёт честное сравнение разных гипотез.
У агента есть память — буфер опыта с лучшими уравнениями и их качеством. В новых итерациях модель видит эти находки и целится в более строгую цель по ошибке. Так поддерживается прогресс на длинном сценарии, даже при ограничении на число шагов и вызовов LLM.
Метрика, на которую ориентируется поиск, — MAPE в процентах. Она удобна, когда масштабы данных разные. Для сопоставимости с другими методами дополнительно отбирают формулу с наименьшим NMSE.
Обучение через подкрепление.
Чтобы агент научился не просто “думать вслух”, а системно доводить гипотезу до хорошего результата, авторы строят синтетический учебный набор по четырём дисциплинам и учат политику через Group Relative Policy Optimization. Награда непрерывная: чем ближе к целевому MAPE, тем выше. Важно, что это снижает разреженность сигнала: агент не ждёт редких “побед”, а видит градиент улучшений.
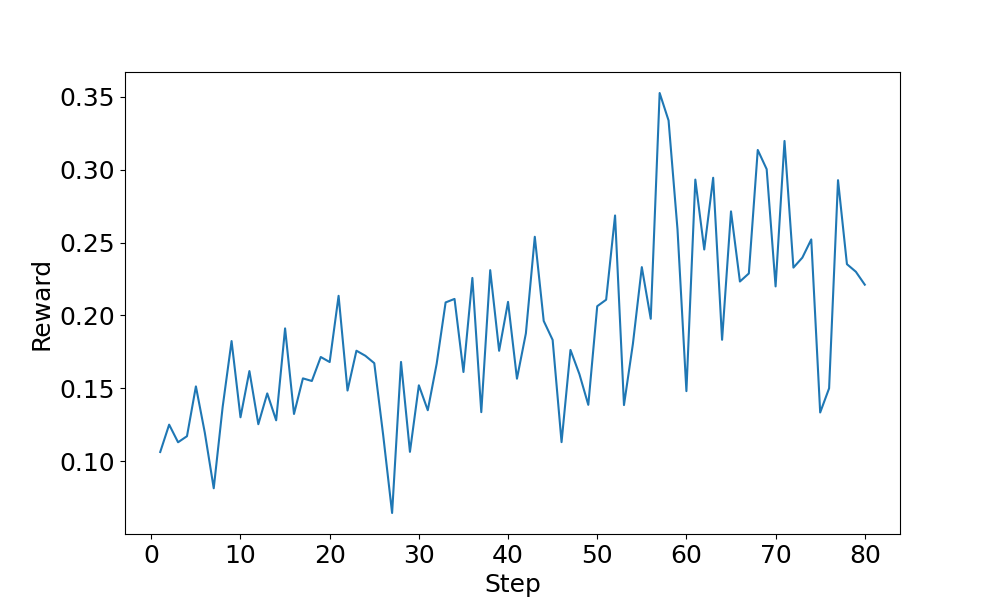
Что показали эксперименты.
Датасет LSR‑Synth покрывает материаловедение, химию, биологию и физику; есть обычные и вне‑доменные тесты. Главная метрика — accuracy‑to‑tolerance: доля примеров, где относительная ошибка укладывается в заданный порог. На таком бенчмарке SR‑Scientist стабильно превосходит бейзлайны. Абсолютный прирост точности — от 6% до 35% в зависимости от домена и модели. На GPT‑OSS‑120B достигается Acc_0.01 = 63.57% и Acc_0.001 = 49.35%. Отдельно заметен вклад обучения с подкреплением: на Qwen3‑Coder‑30B оно поднимает качество во всех дисциплинах.
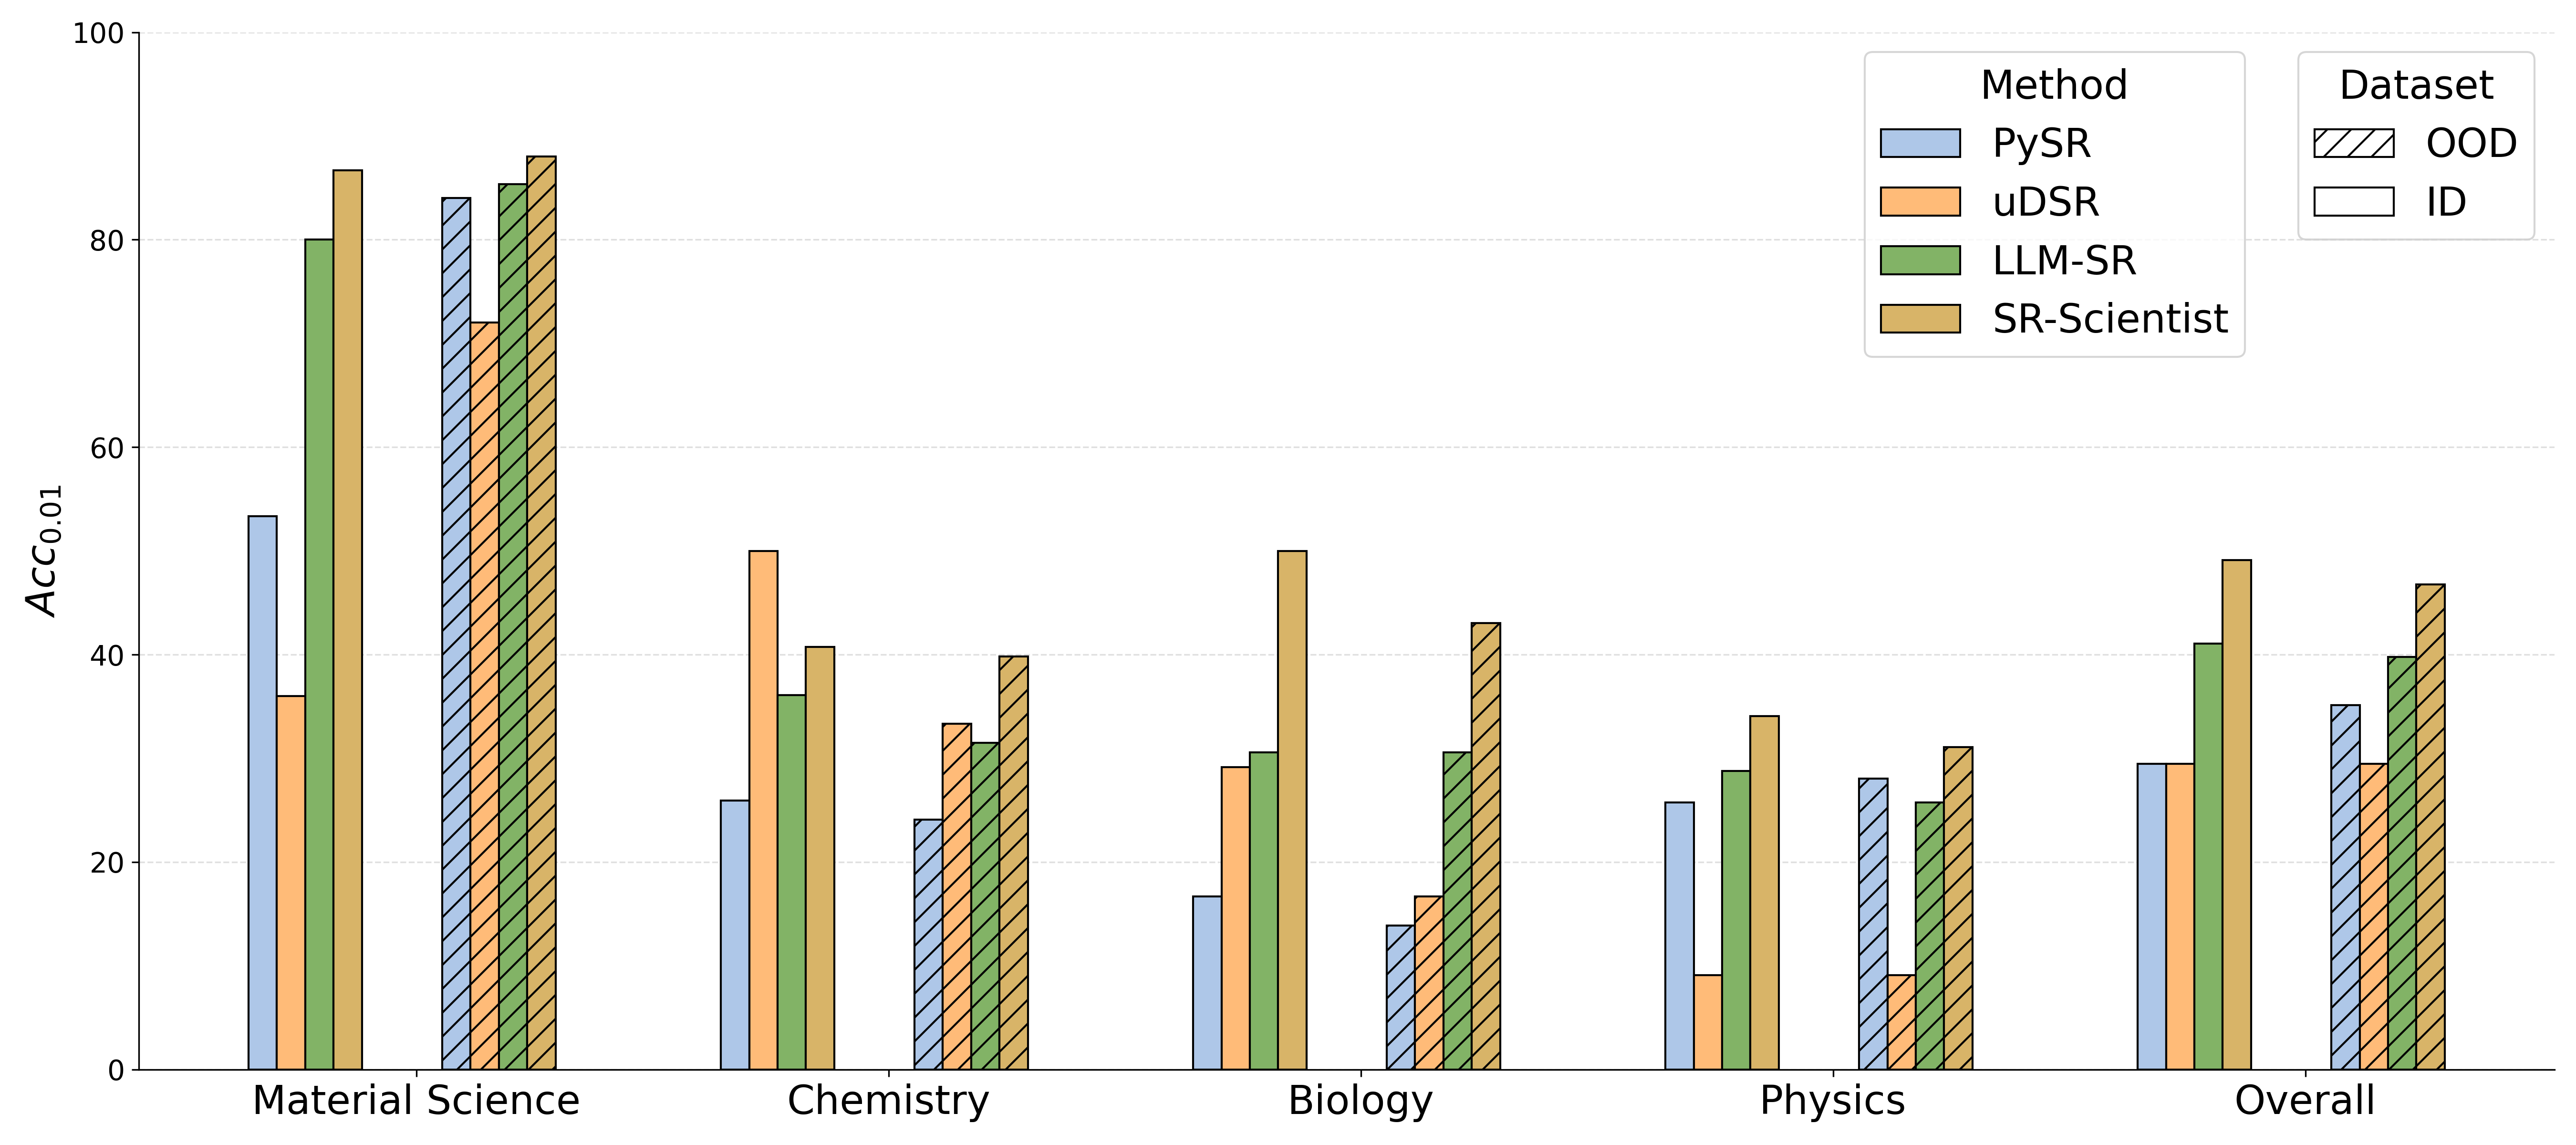

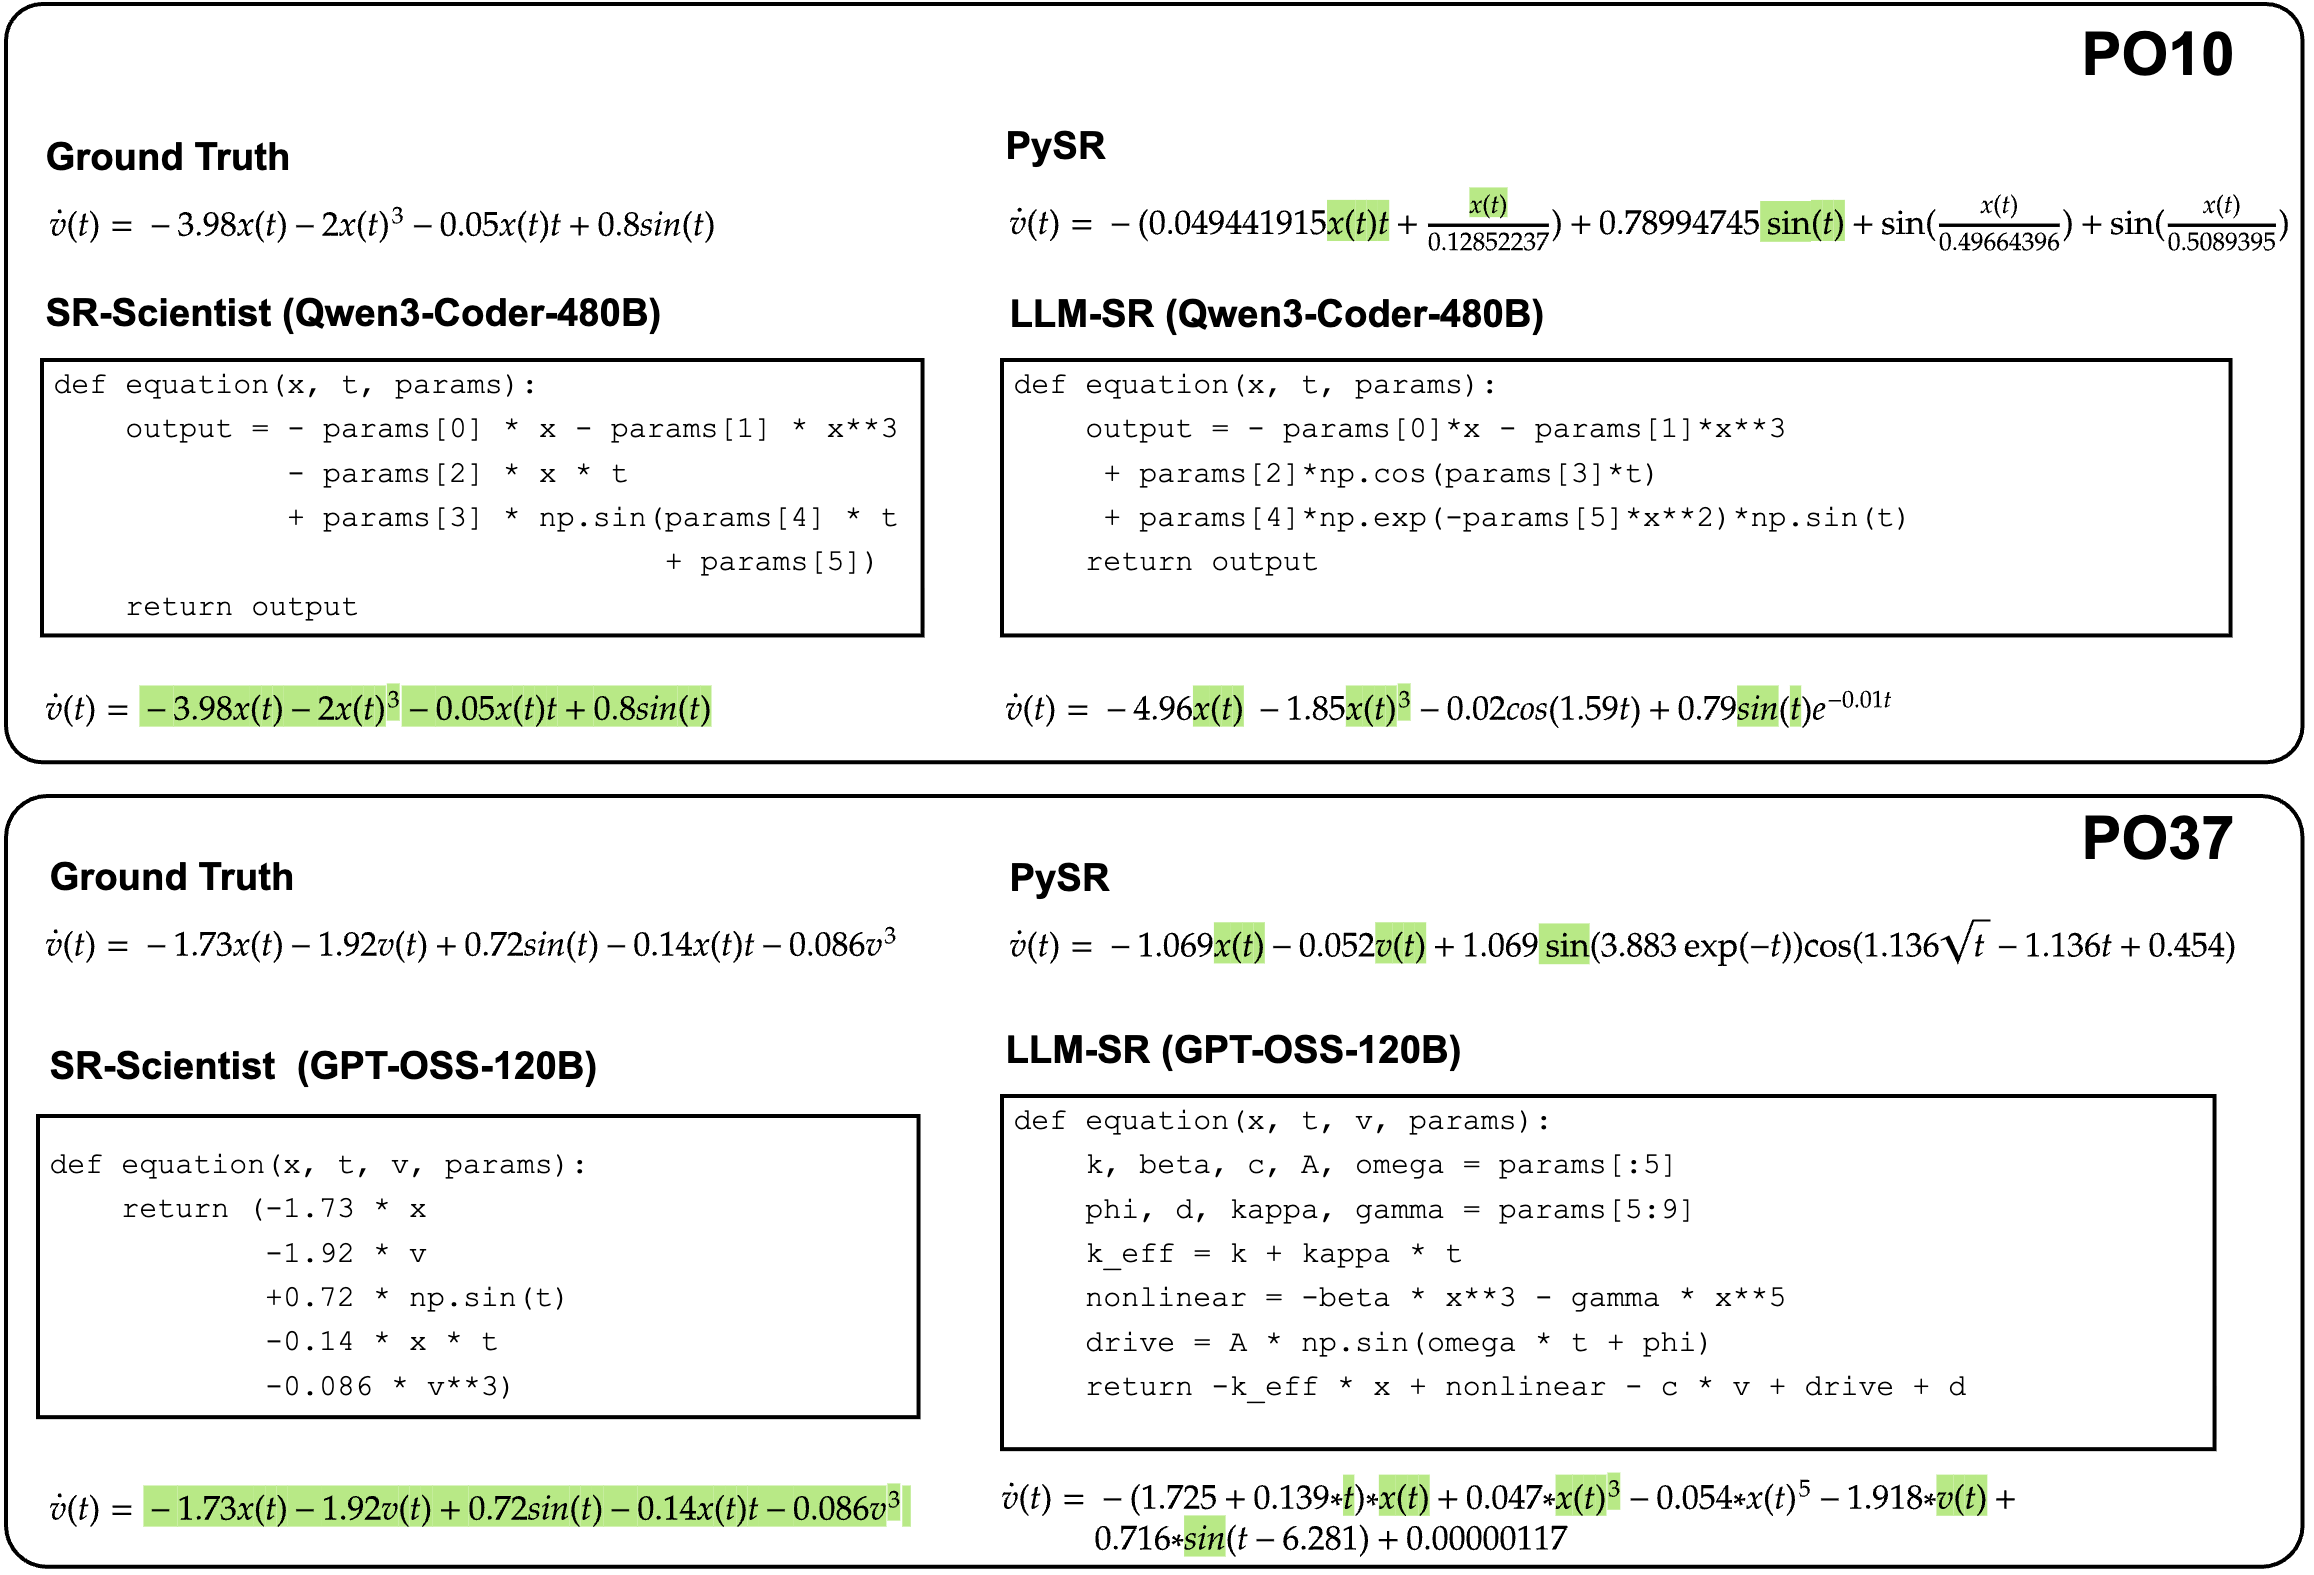
Важна не только численная точность, но и символическая — совпадение структуры формулы с истинной. Здесь агент тоже впереди: 7–8 точных совпадений против 4–5 у лучших конкурентов на тех же настройках. Авторы показывают кейсы из физики, где найденные выражения совпадают с эталоном по ключевым условиям и физическому смыслу.
Что влияет на успех
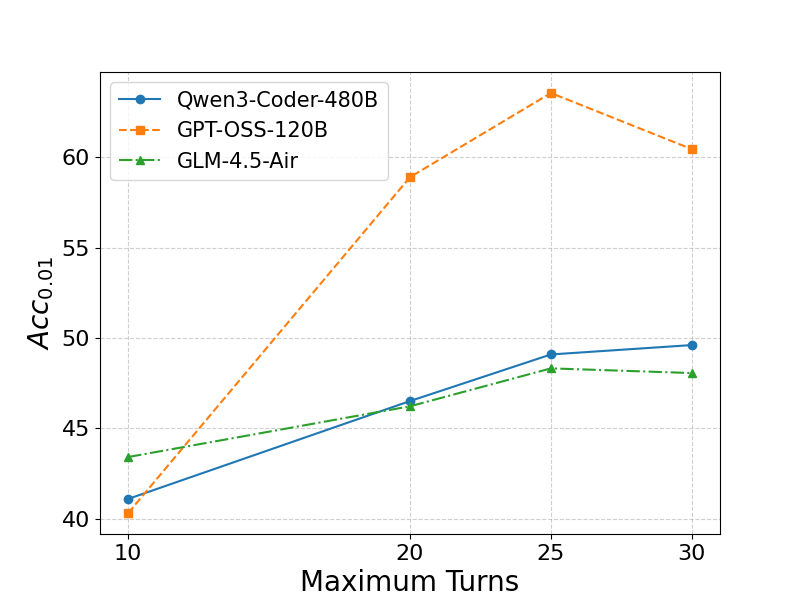
Абляции честно показывают слабые места. Если выкинуть анализ данных, качество заметно падает: агенту трудно понять, где и почему ошибается гипотеза. Если убрать буфер опыта, прогресс рвётся — удачные формы не протаскиваются между итерациями. Ещё один практический момент — баланс длины сценариев и числа итераций: после ~25 шагов на попытку лучше инвестировать ресурс в дополнительные итерации, а не в сверхдлинные рассуждения.
Почему это важно
Большая языковая модель здесь не генератор красивых формул, а активный участник научного процесса. Она строит модель мира на лету: из данных — к гипотезам, через код — к проверке, по обратной связи — к улучшению. Минимум ручного оркестрирования, максимум автономии. Именно такой дизайн и усиливается RL‑обучением: агент учится мыслить длиннее и действовать эффективнее.
Вывод по сути прост: если дать LLM правильные инструменты и научить её жить в длинном горизонте, она начинает работать как внимательный исследователь. SR‑Scientist демонстрирует прирост точности, лучшую переносимость, устойчивость к шуму и более высокую символическую точность — всё то, что важно в реальном научном применении.
Читайте также
 Когда тесты пишутся сами: как ИИ превращает текст в рабочие сценарии тестирования
 Как ИИ-агенты учатся работать в браузере, и почему это может перевернуть будущее веба
 Иллюзия интеллекта: как живые тесты разоблачают ИИ-кодеров
 Как агент учится на ходу: почему память оказалась сильнее дообучения
 Инженирия контекста для саморазвивающихся ИИ-агентов
 Что, если новые бенчмарки для ИИ станут появляться сами по себе?
 Почему тесты на безопасность ИИ-агентов внезапно перестали работать
 Почему ИИ-агенты ошибаются в простых веб-задачах — и как граф знаний помогает им перестать быть тупыми
 Как агенты учатся по видео на YouTube
 Как ИИ научился делать научные видео — от слайдов до говорящей головы
 Графики по щелчку: как ИИ-агенты берут на себя работу дата-аналитика
 Как управлять интернетом вещей с помощью LLM
 Как выжать максимум смысла из тысяч строк кода
 Как ИИ-агенты учатся работать с временными рядами
 Агент-исследователь: как научить LLM работать с поиском в интернете
 Увидел-указал-полетел: как управлять автономными дронами без обучения с нуля
 Что будет, если заставить ИИ-агента работать с тысячами API
 Как думают ИИ-модели: раскладываем рассуждения на эпизоды
 Агентная федерация: как мультиагентные системы учатся работать сообща
 Умеют ли нейросети создавать игры?
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram