Почему маленькие ошибки больших языковых моделей важнее, чем кажутся
Даже самые сильные LLM иногда уверенно произносят факты, которых нет в источниках. В ответах на вопросы достаточно одного неверного слова, чтобы исказить смысл. Большинство проверок сегодня даёт лишь общий вердикт для всего ответа, и почти всё — по‑английски. Авторам PsiloQA было важно сделать наоборот: покрыть 14 языков и научиться находить не просто «неверный ответ», а точные фрагменты текста, где модель ошиблась.
Как устроен PsiloQA
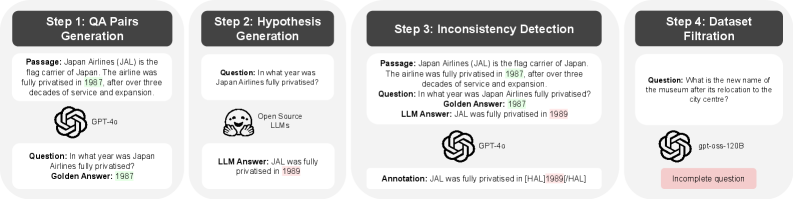
Команда построила полностью автоматизированный пайплайн. Сначала GPT‑4o по фрагментам Википедии создаёт вопросы и эталонные короткие ответы разной сложности. Затем десятки разных LLM отвечают на те же вопросы уже без контекста — так проще спровоцировать уверенные, но необоснованные утверждения. После этого GPT‑4o сравнивает гипотезу модели с эталоном и исходным фрагментом и помечает точные участки ответа, где есть несоответствие. В финале работает фильтрация: удаляются странные вопросы, отказы отвечать и технические огрехи разметки. В итоге остаётся большой чистый корпус реальных, а не искусственно вставленных, ошибок.
Что внутри датасета
PsiloQA — это 14 языков, 63,8 тысяч примеров для тренировки и почти 3 тысячи в тесте. Английский здесь не доминирует: есть хинди, финский, каталонский, китайский, шведский, чешский, фарси, испанский, баскский, французский, итальянский, арабский, немецкий. Часто встречаются короткие галлюцинации длиной до нескольких слов — ровно та гранулярность, которую важно видеть в продуктивных сценариях. По тематикам лидируют география и спорт, но длинный хвост покрывает множество областей.
Пара иллюстративных ошибок: модель уверенно называет, что Лиллиан Рихтер родилась в 1932, хотя в тексте стоит 1915; «Blackpool Stadium» вместо правильного Bloomfield Road; «Amanita rubescens-Team» вместо Russula font-queri. Такие примеры показывают, почему нам нужна разметка на уровне спанов: ошибка в одном токене — и факт уже неверный.
Как сравнивали методы
Авторы проверили три класса подходов:
- Оценка неопределённости по токенам. Это простые и быстрые методы, которые пытаются уловить неуверенность модели.
- Энкодеры, обученные помечать неверные спаны на входе «контекст — вопрос — ответ». В работе обучали ModernBERT и многоязычный mmBERT.
- Подходы с внешними знаниями и LLM‑верификаторами. Например, извлечение фактов и проверка с помощью GPT‑4o.
Оценивали по двум метрикам: площадь под кривой precision–recall (AP) и Intersection over Union (IoU) спанов на уровне символов. Первая показывает, насколько метод хорошо различает корректные и некорректные фрагменты, вторая — насколько точно попадает в границы ошибки.
Что получилось на практике
- Быстрые меры неопределённости дают средний результат: они улавливают часть проблем, но плохо держат точные границы.
- Самыми точными оказались энкодеры, специально обученные на PsiloQA. Особенно сильным вышел мультиязычный mmBERT: в 12 из 14 языков он лучший по обеим метрикам. Это подтверждает, что предобучение на многих языках помогает видеть ошибки даже там, где данные достаточно редки.
- LLM‑проверка фактов с внешним знанием иногда даёт высокий AP, но страдает по IoU — сложно аккуратно очертить место ошибки.
Выяснилось и то, что мультиязычное обучение лучше, чем учить отдельную модель на каждый язык: один mmBERT переносится надёжнее и на близкородственные, и на отличные по письму языки. Ещё важнее — перенос за пределы самого PsiloQA. Модель, обученная только на английской части PsiloQA, существенно обогнала аналоги на англоязычных бенчмарках вроде Mu‑SHROOM и HalluEntity. При этом стоимость автоматической разметки PsiloQA составила около 535 долларов против примерно 3000 на сопоставимый объём ручной англоязычной разметки в RAGTruth.
Почему это важно
PsiloQA показывает, что можно масштабно и дёшево получать разметку реальных ошибок LLM на уровне отдельных фрагментов и сразу по многим языкам. Это снижает порог входа для исследователей и команд, которым нужен тонкий детектор фактических промахов, способный переноситься между языками и задачами. Да, аннотатор один и автоматический, а фокус — только QA по Википедии. Но качественные результаты и хорошая адаптация к разным доменам говорят, что подход уже сегодня практичен.
Читайте также
 Как роботы начинают учиться гораздо быстрее
 Почему линейная регрессия всё ещё обыгрывает трансформеры в анализе временных рядов
 ИИ-ученый, который открывает законы природы без участия человека
 Когда тесты пишутся сами: как ИИ превращает текст в рабочие сценарии тестирования
 Как ИИ-агенты учатся работать в браузере, и почему это может перевернуть будущее веба
 Иллюзия интеллекта: как живые тесты разоблачают ИИ-кодеров
 Как агент учится на ходу: почему память оказалась сильнее дообучения
 Инженирия контекста для саморазвивающихся ИИ-агентов
 Что, если новые бенчмарки для ИИ станут появляться сами по себе?
 Почему тесты на безопасность ИИ-агентов внезапно перестали работать
 Почему ИИ-агенты ошибаются в простых веб-задачах — и как граф знаний помогает им перестать быть тупыми
 Как агенты учатся по видео на YouTube
 Как ИИ научился делать научные видео — от слайдов до говорящей головы
 Графики по щелчку: как ИИ-агенты берут на себя работу дата-аналитика
 Как управлять интернетом вещей с помощью LLM
 Как выжать максимум смысла из тысяч строк кода
 Как ИИ-агенты учатся работать с временными рядами
 Агент-исследователь: как научить LLM работать с поиском в интернете
 Увидел-указал-полетел: как управлять автономными дронами без обучения с нуля
 Что будет, если заставить ИИ-агента работать с тысячами API
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram