Почему ИИ-агенты для интерфейсов учатся в симуляции лучше, чем в реальности
ИИ-агенты сильно зависят от данных: им нужны тысячи разнородных сценариев работы с сайтами и мобильными приложениями. Создать такой набор руками тяжело и дорого. Даже сотни задач с длинными цепочками действий — это тысячи часов разработки, аннотаций и инфраструктуры. Авторы UI-Simulator предлагают альтернативу: не собирать всё в реальных средах, а синтезировать богатые состояния интерфейсов и сценарии действий напрямую с помощью LLM. Главная ставка — разнообразие миров и устойчивость к изменению верстки, контента и логики.
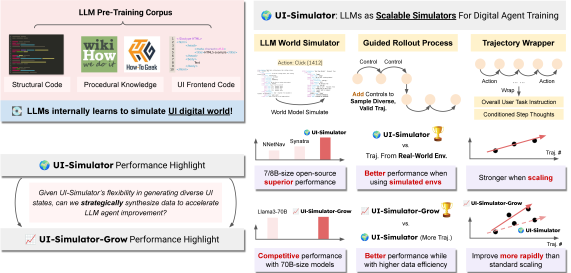
Идея в двух словах
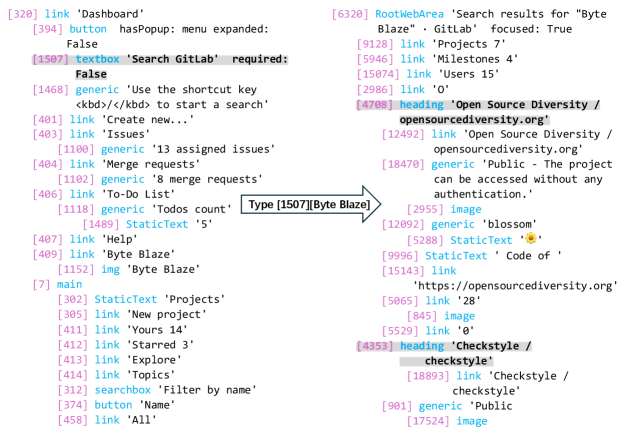
Команда строит модель мира поверх LLM, которая генерирует следующее UI‑состояние по текущему состоянию и действию. На этом симуляторе запускают управляемые проходы, а затем превращают их в обучающие примеры. Получается «фабрика сценариев» без разворачивания реальных сайтов и приложений.
Фреймворк держится на трех китах:
- LLM‑симулятор цифрового мира: синтезирует новые правдоподобные UI‑состояния и переходы.
- Управляемое развертывание: пошаговый контроль целей, чтобы проходы были связными и разнообразными.
- Обёртка над сценариями: превращает проходы в чистые обучающие сценарии с инструкцией, действиями и рассуждением.
Как работает симулятор мира
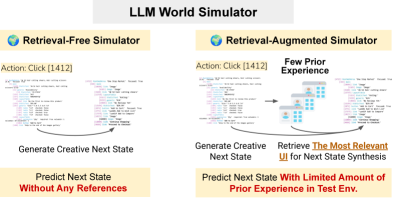
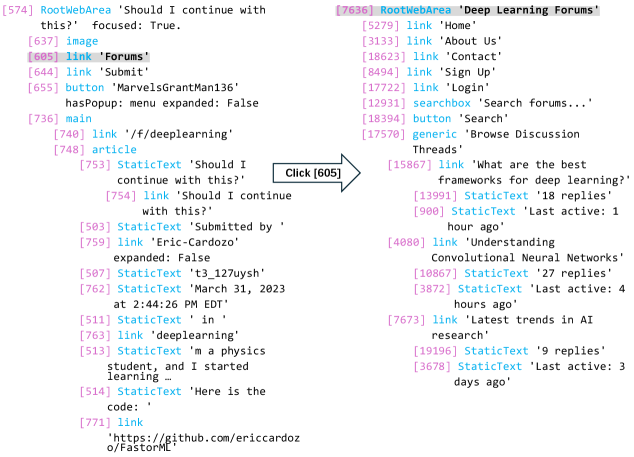
Состояние интерфейса представляют как дерево доступности с текстом, координатами и динамическими атрибутами. Симуляция многошаговая: сначала краткий обзор того, что должно появиться дальше, затем «черновик» страницы на естественном языке, и только потом строгая структуризация с координатами. Детерминированные вещи вроде прокрутки моделируются правилами. Для быстрой адаптации к новой среде добавляют ретривер: он подтягивает похожие наблюдения и делает следующий шаг реалистичнее, даже если прямого опыта в этой среде почти нет.
Как собирать данные без явной инструкции
Обычный сбор данных застревает на шаблонных действиях и неочевидных ошибках. Здесь учитель на базе GPT‑4o‑mini ведёт пошаговое исследование с краткими контролями задач. Он сам делит поиски на подцели, генерирует мысль, действие и короткий резюме‑шаг. В конце wrapper суммирует историю в понятную пользовательскую цель и перезаписывает мысли так, чтобы они соответствовали финальной инструкции. Фильтры убирают невалидные клики и логические несоответствия. В итоге на выходе — компактные, валидные, хорошо читаемые сценарии.
Что даёт прицельное масштабирование
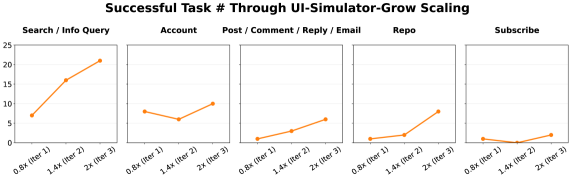
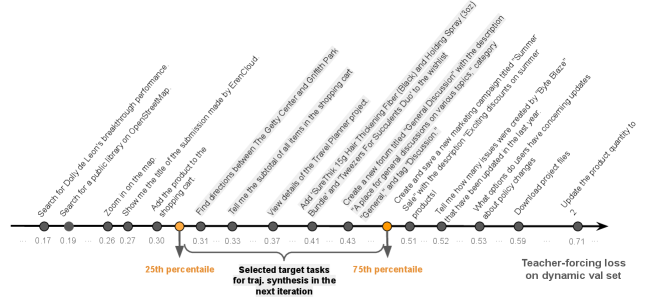
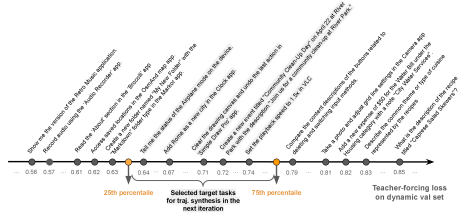
Слепое наращивание данных помогает не всегда. UI‑Simulator‑Grow выбирает задачи, которые сильнее всего двигают модель вперёд: сортирует их по teacher‑forcing loss и берёт среднюю «полезную» часть, исключая слишком простые и слишком шумные. Затем синтезирует содержательные вариации этих задач, сохраняя логику действий и меняя сущности. Есть и реплей из прошлых итераций, чтобы не забывать навыки.
Что получилось на практике
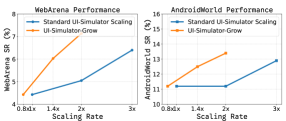
Тесты на WebArena и AndroidWorld показывают, что даже базовая версия без контакта с реальными средами серьёзно поднимает планку: с 2–5% SR у исходных моделей до 6.28% на WebArena и 8.6% на AndroidWorld. С ретривером результат растёт до 6.40% и 12.9% соответственно. Версия Grow достигает 7.14% на WebArena и 13.4% на AndroidWorld — сопоставимо с более крупными или дорогими моделями. Важно, что учитель здесь слабее (GPT‑4o‑mini), тогда как конкуренты опираются на GPT‑4o. На AndroidWorld модель на 8–7B параметров с синтетикой догоняет и местами обгоняет куда более тяжёлых соперников. Человеческая проверка тоже подтверждает качество: по большинству критериев доли удовлетворенности около и выше 90%.

Почему симуляция иногда лучше реальности
Абляции показывают: если собирать столько же данных прямо в реальной среде, получается хуже. Реальные сайты дают узкий и предсказуемый опыт: одинаковые настройки, мало неудачных переходов, редкие «краевые» случаи. Симулятор генерирует больше разнообразных и полезных переходов, а агенты от этого становятся устойчивее к перестановкам макета и новым вариантам страниц. Отказ от пошагового контроля или упрощение симуляции до одного шага резко ломают качество и разнообразие.
Но слабые места тоже есть. Иногда симулятор путает контекст после клика или чрезмерно полагается на ретривер и вытаскивает нерелевантное состояние. Авторы честно показывают такие кейсы и используют их для доработки промтов и отбора данных.
Что это значит для нас
Исследование показывает, что большая языковая модель уже может играть роль общей модели мира для интерфейсов. Без дообучения и без развертывания сложной инфры она создает тренд на дешёвое и масштабируемое обучение агентов. Прицельное масштабирование ещё и экономит данные: на WebArena достаточно примерно двух третей синтетических сценарии, чтобы догнать уровень 70B‑моделей. Дальше — выход на десктопные сценарии и постепенное движение к пикселям, чтобы сократить разрыв между симуляцией и реальностью.
Читайте также
 Агентная операционная система — новая парадигма взаимодействия человека и машины
 Эпоха автономных аналитиков: как ИИ меняет науку о данных
 Как ИИ-очки предсказывают ваши желания прежде чем вы о них подумаете
 Почему маленькие ошибки больших языковых моделей важнее, чем кажутся
 Как роботы начинают учиться гораздо быстрее
 Почему линейная регрессия всё ещё обыгрывает трансформеры в анализе временных рядов
 ИИ-ученый, который открывает законы природы без участия человека
 Когда тесты пишутся сами: как ИИ превращает текст в рабочие сценарии тестирования
 Как ИИ-агенты учатся работать в браузере, и почему это может перевернуть будущее веба
 Иллюзия интеллекта: как живые тесты разоблачают ИИ-кодеров
 Как агент учится на ходу: почему память оказалась сильнее дообучения
 Инженирия контекста для саморазвивающихся ИИ-агентов
 Что, если новые бенчмарки для ИИ станут появляться сами по себе?
 Почему тесты на безопасность ИИ-агентов внезапно перестали работать
 Почему ИИ-агенты ошибаются в простых веб-задачах — и как граф знаний помогает им перестать быть тупыми
 Как агенты учатся по видео на YouTube
 Как ИИ научился делать научные видео — от слайдов до говорящей головы
 Графики по щелчку: как ИИ-агенты берут на себя работу дата-аналитика
 Как управлять интернетом вещей с помощью LLM
 Как выжать максимум смысла из тысяч строк кода
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram