Как измерить «общий научный интеллект» у LLM
Сегодня LLM умеют многое: объяснять сложные темы, писать код, держать длинную нить рассуждений. Но наука — это не только вызубрить ответы. Это исследовательский цикл: разобраться в литературе, придумать гипотезу, проверить ее экспериментом, а потом честно интерпретировать результаты и скорректировать план. И вот здесь у сообщества долго не было общего языка и измерителя: что именно считать «научным интеллектом» ИИ и как проверять его не на отдельных задачках, а на рабочем процессе, похожем на реальную работу исследователя.
Ученые из Шанхайского ИИ-университета выпустили исследование Probing Scientific General Intelligence of LLMs with Scientist-Aligned Workflows, в котором предлагают ответ: они вводят практичное определение Scientific General Intelligence (SGI) и строят бенчмарк, который проверяет не «эрудицию», а способность модели проходить этапы научного исследования.


Научный цикл как измеримая рамка
Вместо абстрактных разговоров о «почти AGI» авторы опираются на Practical Inquiry Model — модель практического исследования с четырьмя связными стадиями. В человеческой науке они постоянно повторяются: сначала мы собираем и критически оцениваем знания, затем формируем идею, дальше делаем эксперимент, а после пытаемся понять, что на самом деле произошло.
Этот фреймворк ученые превращают в четыре типа задач, максимально похожих на то, что делает исследователь:
- глубокое научное исследование по источникам, где важны не общие слова, а точные выводы, часто численные;
- генерация исследовательских идей, но с требованием продуманной реализации;
- эксперименты — от дописывания научного кода до планирования лабораторного протокола;
- рассуждение по данным и изображениям, включая сравнение условий и причинные выводы.

Как собран SGI-Bench и почему это важно
Сам бенчмарк SGI-Bench — это больше тысячи междисциплинарных примеров. Темы вдохновлены списком Science’s 125 Big Questions, а данные и вопросы проходят многоступенчатую проверку. В сборке участвовали исследователи уровня магистров и PhD, а затем вопросы дополнительно чистились правилами, проверялись моделями и доменными экспертами.
Отдельно любопытен ход с «фильтрацией сложности»: авторы прогоняли задания на нескольких сильных моделях, и то, что оказывалось слишком легким, выкидывали. Это заметно меняет характер бенчмарка: он меньше похож на «экзамен на память» и больше — на стресс‑тест устойчивости.

Как оценивают модели: недостаточно просто спросить «кто прав»
Проблема научных заданий в том, что «LLM-судья» часто дает слишком шумные оценки: разные домены требуют разных метрик, а иногда нужно реально выполнить код или проверить формат протокола. Поэтому авторы строят агентную оценку: не один «судья‑текстогенератор», а система, которая может подключать инструменты вроде интерпретатора Python, парсера PDF и специализированных метрик.

Что получилось: сильные фрагменты вместо цельного научного поведения
Картина в итоге довольно трезвая. Даже лучшие модели набирают около 30 из 100 по сводному SGI‑Score. И это важный сигнал: сегодня LLM могут выглядеть уверенно на отдельных умениях, но «склеить» их в надежный научный рабочий процесс пока не выходит.
В «глубоком исследовании» пошаговое рассуждение иногда выглядит разумно, но финальный точный ответ часто неверен — exact match держится в районе 10–20%. То есть модель может искать информацию корректно, но плохо работать с числами, единицами измерений, интеграции источников или на последнем переходе.

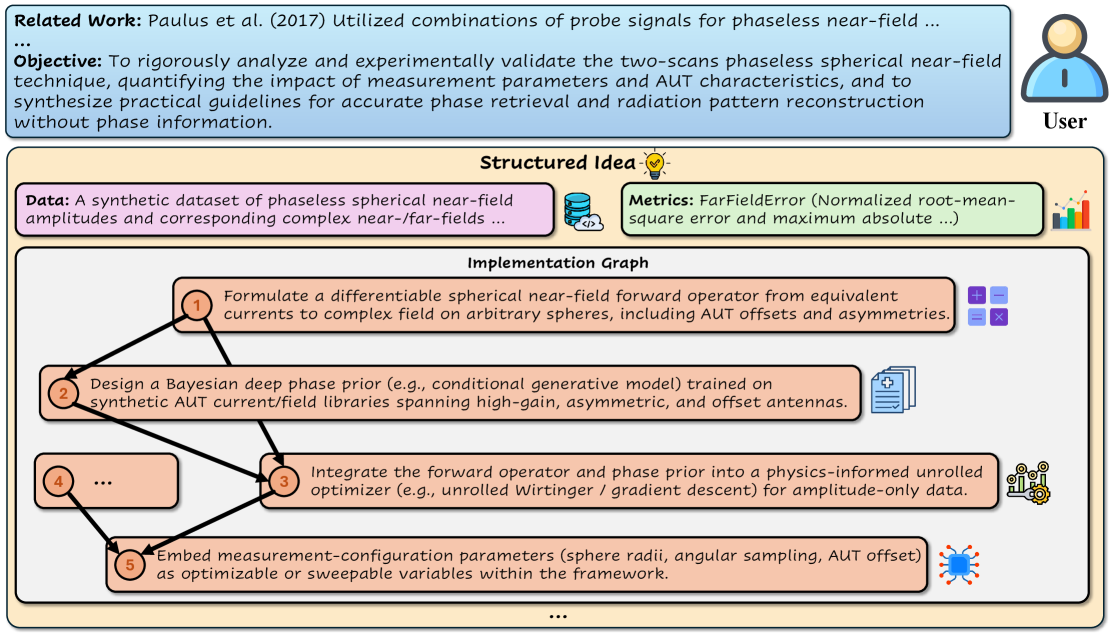
Генерация идей выглядит хорошо: модели действительно предлагают необычные комбинации подходов. Но у идей хронически слабое место — реализуемость. Часто не хватает приземленных деталей: откуда берутся данные, как устроен пайплайн, в каком порядке запускать шаги, какие ресурсы нужны, как проверять гипотезу так, чтобы эксперимент можно было повторить.
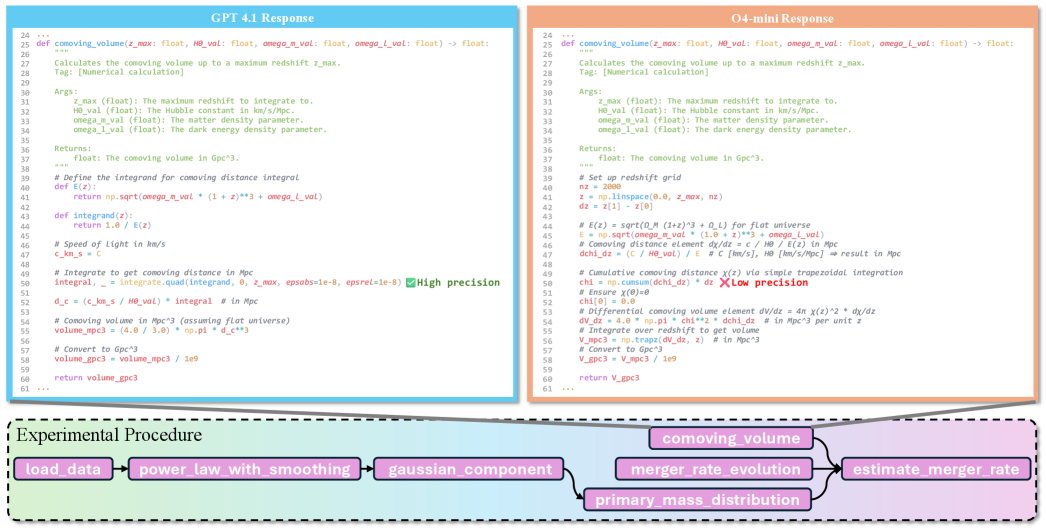
В "сухих" экспериментах вскрывается типичная боль «код пишется, но наука не считается». Исполняемость может быть высокой, а вот научная корректность — низкой. Особенно часто модели ошибаются в численных методах и симуляциях: где важен не синтаксис, а выбор устойчивого алгоритма.
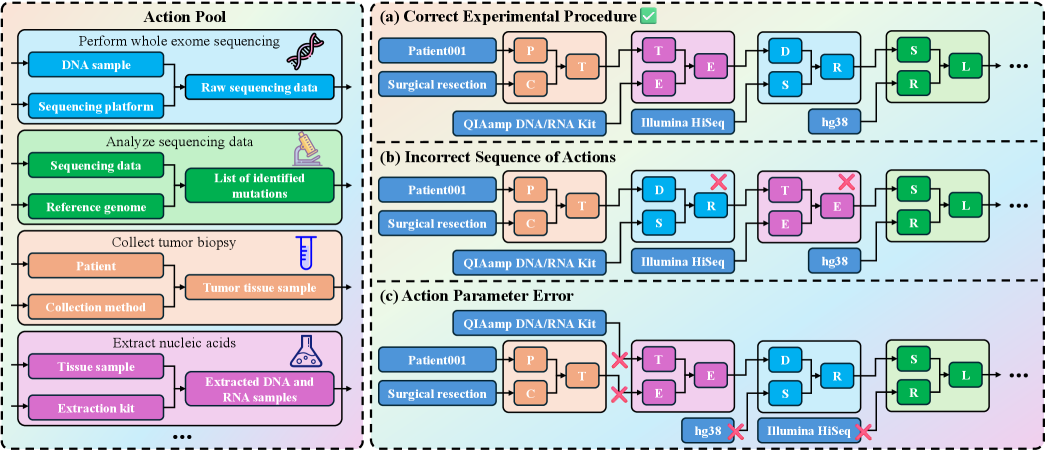
С "мокрыми" экспериментами все еще интересней: протоколы требуют порядка действий, таймингов, ветвлений, учета образцов. Модели нередко «схлопывают» сложный процесс в линейный список шагов и теряют логику эксперимента.
Наконец, в мультимодальном экспериментальном рассуждении модели лучше справляются с распознаванием сигналов и причинными подсказками, но стабильно проседают в сравнительном анализе: когда нужно аккуратно сопоставить несколько условий и не перепутать, что именно отличается.

Попытка усилить «научную креативность» прямо на инференсе
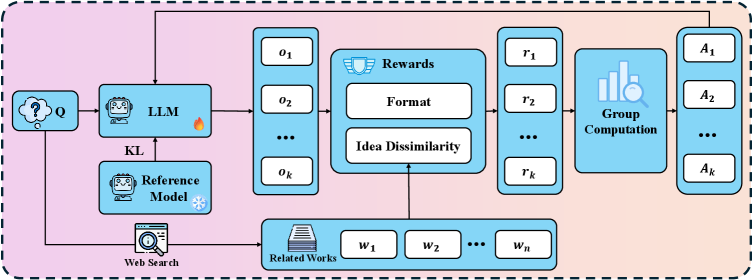
Отдельный интересный кусок — Test-Time Reinforcement Learning. Авторы пробуют улучшать генерацию идей без «правильных ответов»: модель получает награду за новизну относительно найденных публикаций (через retrieval) и постепенно учится предлагать менее тривиальные гипотезы. Это не решает проблему реализуемости автоматически, но показывает направление: научные навыки можно прокачивать динамически, когда разметка невозможна.
Что это меняет в научном ИИ
Главная ценность работы — в честной «приземленной» постановке вопроса. SGI здесь не мистическое свойство и не философия, а проверяемая способность проходить научный цикл: от литературы до интерпретации результатов. И результаты довольно ясно говорят: сегодняшние LLM сильны в отдельных компонентах, но пока недостаточно надежны там, где наука требует точности, процедурной дисциплины и устойчивых численных методов.
Для разработчиков это означает простую вещь: следующий прогресс, вероятно, будет не только в размере моделей, а в связке использования инструментов, проверках, самокоррекции, доменных симуляторах и обучении.
Читайте также
 Как ИИ-агенты решают задачи международной олимпиады по математике
 Как писать README-файлы для ИИ-агентов
 Как ИИ-агенты живут в "Станции" и делают научные открытия
 DataFlow: PyTorch для дата инженеров в эпоху LLM
 Когда цифр недостаточно: язык как скрытый сигнал в экономических ИИ-моделях
 Когда тесты молчат: как ИИ-агент чинит баги
 ИИ-агент против людей-безопасников: кто кого в реальном пентесте?
 DeepCode: как ИИ научился собирать репозиторий по статье
 Когда команда ИИ-агентов помогает, а когда делает только хуже
 Matrix: распределенный мультиагентный фреймворк для генерации синтетических данных
 Как сделать интернет удобным для ИИ-агентов
 Как ИИ-агенты научились рефакторить код: что получается хорошо, а что не очень
 Как универсальный ИИ-агент учится жить в открытом мире
 Как обучить ИИ работать за компьютером
 Почему мышление через видео может быть следующим шагом в развитии ИИ
 Как ИИ-ученый пишет научные статьи о машинном обучении на уровне джуна
 От пикселей к смыслу: как SVG помогает ИИ понимать мир
 Как ИИ-браузер ChatGPT Atlas разгадал судоку за пару минут, но проиграл в Flappy Bird
 Децентрализованный ИИ: как рой нейросетей побеждает большие модели
 ИИ в белом халате: как он учится ставить диагнозы в виртуальной клинике
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram