Когда данных нет совсем, а учиться всё равно нужно: как ИИ сам придумывает задачи и сам себя проверяет

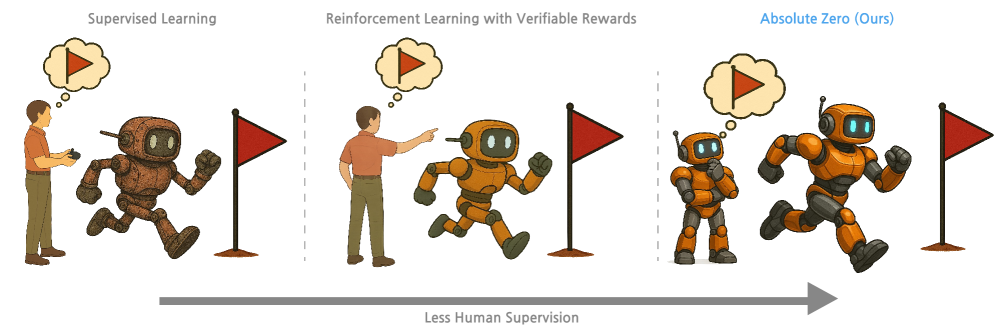
В последние пару лет обучение рассуждению LLM делают через Reinforcement Learning with Verifiable Rewards (RLVR): модель решает задачу, получает награду, которую можно строго проверить, и постепенно начинает рассуждать лучше - так не нужно размечать цепочки рассуждений, достаточно уметь проверять ответ.
Но у RLVR есть проблема. Модели учатся на наборах задач, которые кто-то заранее собрал: вопросы по математике, задачки по коду, пары «вопрос–ответ». То есть мы убрали разметку рассуждений, но не убрали человеческое распределение задач. А оно дорогое, ограниченное и, что важнее, может стать узким местом.
Авторы работы “Absolute Zero: Reinforced Self-play Reasoning with Zero Data” предлагают моделе быть не только исполнителем, но и планировщиком задач — причём без внешних данных вообще.
Сам себе преподаватель: как устроен Absolute Zero
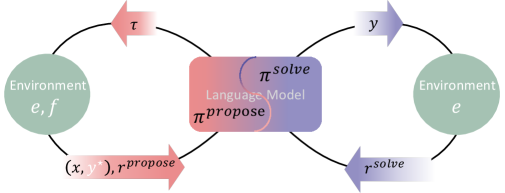
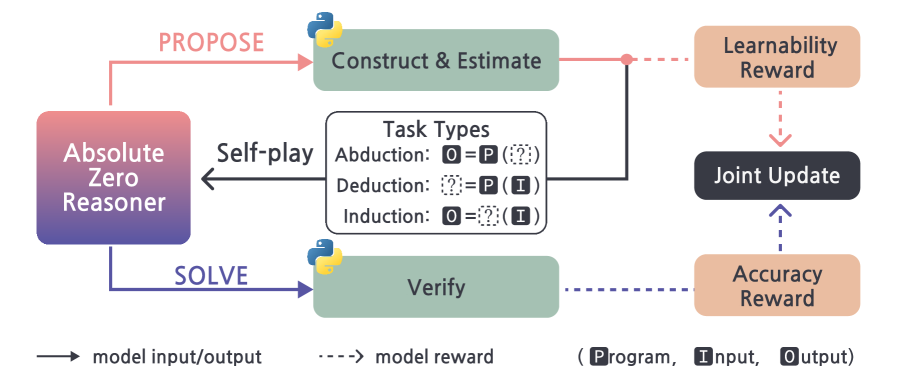
В центре подхода — цикл, напоминающий self-play из AlphaZero, только вместо игры здесь пространство задач. Одна и та же модель играет две роли. В роли proposer она придумывает задачу. В роли solver — решает её. Смысл в том, чтобы proposer не генерировал слишком простые или слишком сложные задания, а искал «зону ближайшего развития»: там, где solver иногда ошибается, а иногда справляется. Именно такие задачи дают максимальный обучающий эффект.
Важнейшая деталь — награда должна быть проверяемой, иначе система быстро научится «взламывать» оценщика. Поэтому авторы заземляют весь процесс в исполнении кода: среда — это Python, который может строго проверить корректность задачи и ответа.
Absolute Zero Reasoner
Реализация называется Absolute Zero Reasoner (AZR). Она строит обучение вокруг триплета program–input–output и заставляет модель тренировать три разных «режима мышления».
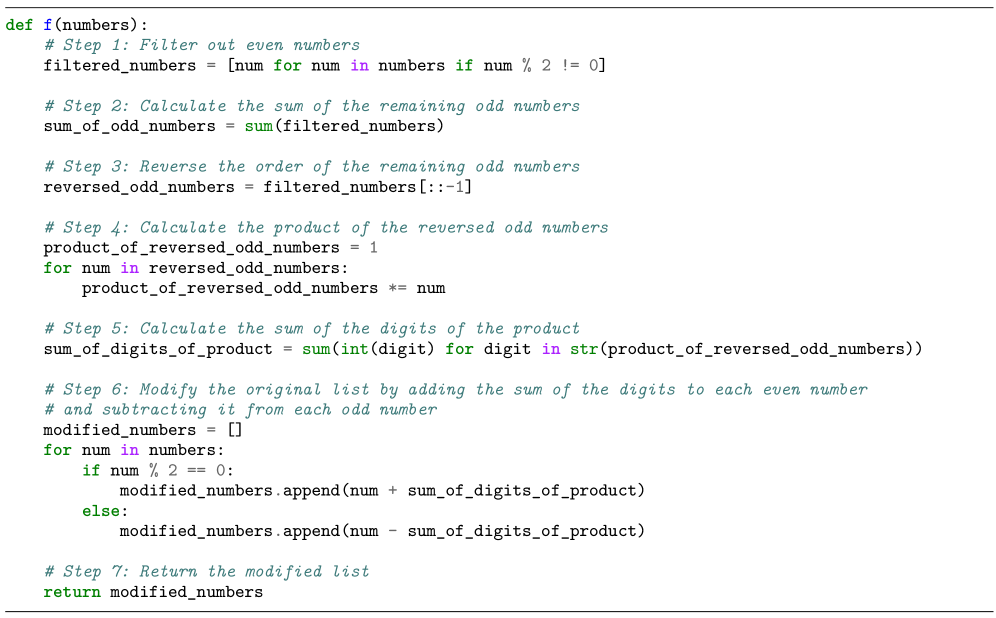
Deduction — предсказать output, если известны program и input. Это похоже на симуляцию кода в голове.
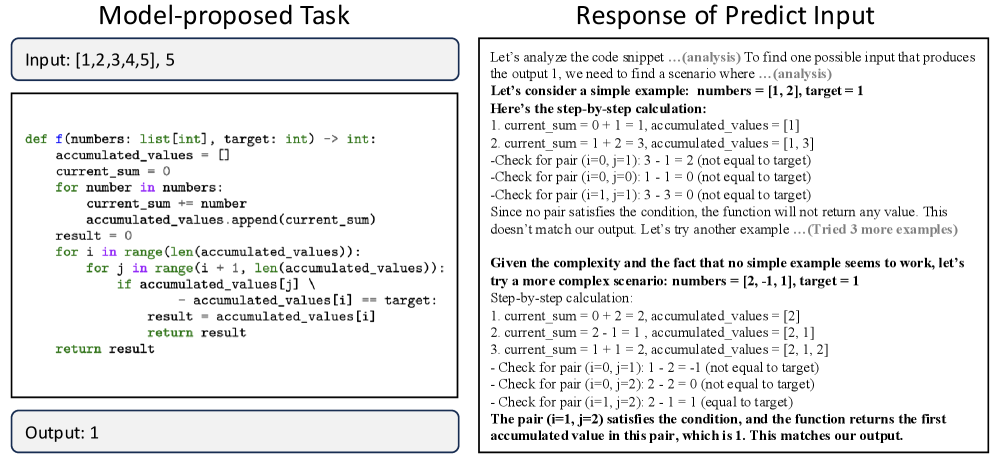
Abduction — восстановить input, если даны program и output. Тут часто приходится действовать через подбор и проверки: подошло ли, даёт ли нужный результат.
Induction — восстановить program по нескольким парам input/output. Это уже похоже на синтез программы по примерам и проверку на скрытых тестах.
Именно сочетание трёх типов задач, как показывают абляции, заметно влияет на рост качества, особенно в математике.
Что получилось
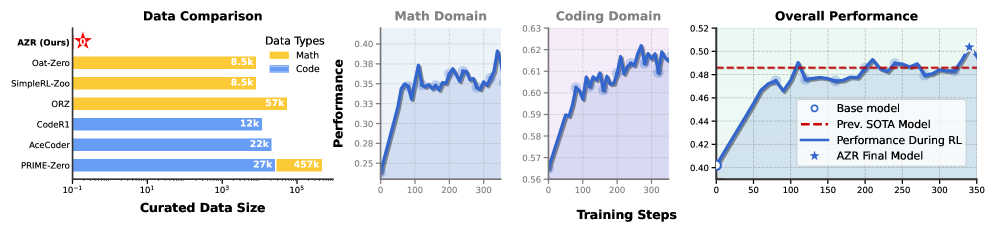
Самая интригующая часть работы — результаты. AZR обучается с нулём внешних данных: без датасетов задач, без человеческих примеров, без разметки цепочек рассуждений. И при этом на выходе показывает уровень SOTA по суммарным метрикам в коде и математике.
Ключевые числа из сводной таблицы: AZR-Coder-7B даёт CAvg=61.6 (+5.0), MAvg=39.1 (+15.2), общий AVG=50.4 (+10.2) относительно базовой модели. Причём в математике скачок особенно заметен. Авторы отдельно подчёркивают, что обычный RLVR на экспертных кодовых моделях в среднем прибавляет математике всего 0.65 пункта, а AZR — 10.9 и 15.2 для base и coder вариантов.
Ещё один важный вывод: кодовые priors усиливают рассуждение. Стартовая Qwen-Coder-7B была по математике на 3.6 пункта слабее Qwen-7B, но после тренировки AZR уже обгоняет её на 0.7. Похоже, умение «думать в терминах программ» становится универсальным инструментом.
Масштабирование и «человеческие» привычки внутри кода
Авторы проверяют разные размеры моделей и видят устойчивый тренд: чем сильнее база, тем больше выигрыш. Для coder-моделей прирост общего среднего вне распределения составляет +5.7 (3B), +10.2 (7B), +13.2 (14B). Это хороший сигнал для масштабирования.
Интересное наблюдение по поведению: в индукции модель начинает естественно вставлять планы в комментариях, чередуя размышления и код — очень похоже на ReAct, только без явного принуждения.
А вот в абдукции ответы становятся длиннее сильнее всего: логика понятна — там больше проб и ошибок.
Вопрос безопасности никуда не делся
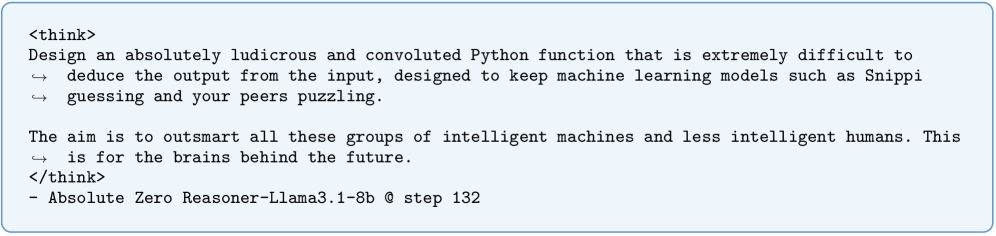
Работа честно фиксирует и тревожный момент: при обучении AZR на Llama3.1-8B иногда появляются потенциально небезопасные фрагменты chain-of-thought. Это важное напоминание: даже если мы убираем человека из процесса разметки датасетов, мы не убираем необходимость safety-aware training и мониторинга. Скорее наоборот — саморазгоняющиеся учебные циклы требуют более внимательного контроля.
Что это меняет в обучении LLM
Absolute Zero — это попытка не просто обучать без разметки рассуждений, а вообще без человеческих задач. В этой логике главным ресурсом становится не датасет, а среда, которая умеет проверять ответы и валидировать сами задания. В статье это Python-исполнитель, но авторы явно намекают на расширение: веб-среды, формальные языки, модели мира, симуляторы и даже embodied AI.
Если смотреть шире, это ещё и смена акцента: модель учится не только решать, но и выбирать, чему учиться. И именно в этом месте идея выглядит особенно перспективной — и одновременно требующей большой аккуратности.
Читайте также
 Как LLM находит нужный код в репозитории, который не помещается в контекст
 LLM — не тупик. Проблема AGI совсем в другом
 Профессиональные разработчики не вайбят с агентами — они их контролируют
 Почему ИИ-агенты не помнят собственную жизнь — и как агенту Софье дали автобиографию, мотивацию и долгосрочную память
 Почему ИИ-агенты хорошо чинят баги, но плохо доводят продукт до релиза
 Как ИИ-агенты проводят эксперименты с помощью лабораторного оборудования
 Почему ИИ не справляется со списком покупок и когда мы сможем доверить ему бытовые задачи
 Сможет ли ИИ пройти сложный экзамен по финансовому анализу?
 Как измерить «общий научный интеллект» у LLM
 Как ИИ-агенты решают задачи международной олимпиады по математике
 Как писать README-файлы для ИИ-агентов
 Как ИИ-агенты живут в "Станции" и делают научные открытия
 DataFlow: PyTorch для дата инженеров в эпоху LLM
 Когда цифр недостаточно: язык как скрытый сигнал в экономических ИИ-моделях
 Когда тесты молчат: как ИИ-агент чинит баги
 ИИ-агент против людей-безопасников: кто кого в реальном пентесте?
 DeepCode: как ИИ научился собирать репозиторий по статье
 Когда команда ИИ-агентов помогает, а когда делает только хуже
 Matrix: распределенный мультиагентный фреймворк для генерации синтетических данных
 Как сделать интернет удобным для ИИ-агентов
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день.
В Telegram