Как ИИ-агенты собирают презентации нового поколения с голосом, видео и интерактивом
Когда нейросеть уже не делает слайды, а проводит целую презентацию
Генерация презентаций долго жила в довольно скучном режиме: есть документ, есть набор тезисов, модель превращает всё это в слайды. Полезно, но предсказуемо. Новая работа PresentAgent-2 пытается заметно поднять планку. Здесь системе дают не статью, не отчёт и даже не готовый конспект, а короткий пользовательский запрос вроде «объясни flow matching». Дальше агент сам ищет материалы, собирает визуальные подтверждения, пишет сценарий, озвучивает его и монтирует полноценное видео презентации.
Это уже не «автогенератор слайдов», а зачаток цифрового докладчика. Причём докладчика с несколькими режимами: он может выступать один, может разыгрывать обсуждение между несколькими спикерами, а может ещё и отвечать на вопросы аудитории по ходу дела. Для рынка образования, корпоративного обучения, технической документации и научпопа это направление выглядит очень практичным: пользователю часто нужен не документ, а готовое объяснение.
Что именно предлагают авторы
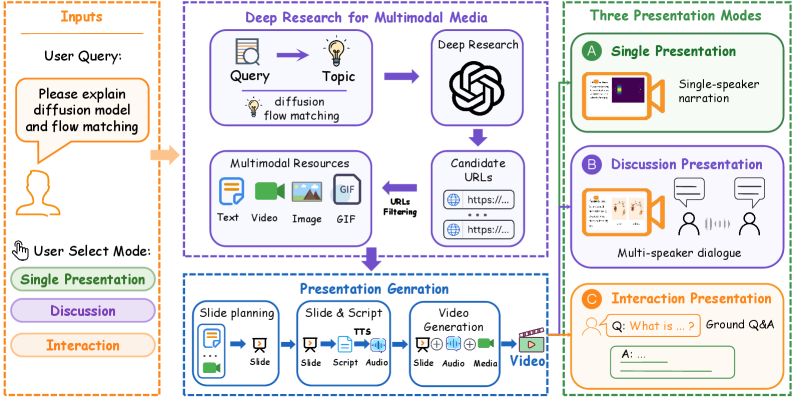
Главная идея статьи проста и амбициозна одновременно: превратить открытый запрос в законченное видео презентации, не опираясь на заранее выданный исходный документ. Для этого PresentAgent-2 строится как агентная система из нескольких этапов.
Сначала модель сужает пользовательский запрос до более фокусной темы. Затем запускается этап, который авторы называют «глубоким исследованием»: система ищет подходящие источники в сети, причём не любые, а такие, которые удобны именно для презентации — с хорошим текстом, картинками, анимациями, видеофрагментами. После фильтрации материалов агент собирает мультимодальный набор ресурсов: текст, изображения, GIF-анимации и ролики.
Дальше начинается собственно производство презентации: строится структура, генерируются слайды, пишется сценарий, синтезируется речь и собирается итоговое видео. Важный штрих: GIF и видео не превращают в статичные снимки экрана, а сохраняют как динамический контент внутри слайдов. Это мелочь только на словах. На практике именно такие движущиеся примеры часто лучше всего объясняют алгоритм, интерфейс или физический процесс.
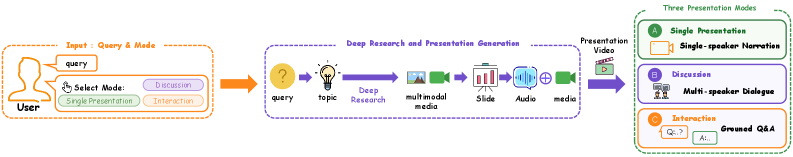
Система поддерживает три режима:
Это, пожалуй, самый сильный концептуальный ход статьи. Авторы не просто автоматизируют упаковку контента, а моделируют способы подачи знания.
Почему это важно
На первый взгляд может показаться, что это просто следующий шаг после генерации слайдов. Но в реальности задача заметно сложнее и интереснее.
Большинство прежних систем предполагали, что пользователь уже приносит «сырьё»: статью, отчёт, запись в блоге, набор заметок. Тогда модели остаётся сжать, перестроить и визуализировать готовый материал. PresentAgent-2 работает в более жизненном сценарии: человек формулирует намерение, а не предоставляет источник. Это ближе к тому, как люди действительно пользуются ИИ.
Разница здесь фундаментальная. Если исходного документа нет, системе нужно:
То есть задача сдвигается от оформления к исследованию, отбору и объяснению. Именно поэтому работа важна: она показывает, как LLM и визуально-языковые модели могут переходить от «пересказчиков документов» к более автономным агентам знания.
Как устроена методология
Авторы не ограничились демонстрацией красивых примеров и собрали собственный бенчмарк для оценки таких систем. Это отдельный сильный момент статьи: без внятной проверки подобные работы быстро превращаются в набор впечатляющих роликов без ясного понимания, что там действительно работает.
В бенчмарк вошло 60 пар «запрос — эталонное видео», по 20 примеров на каждый режим: одиночная презентация, дискуссия и интерактив. Эталонные видео брали из публичных образовательных и профессиональных источников. Важно, что модели на вход дают только запрос, а не тот документ, из которого когда-то было сделано эталонное видео.
Оценка построена в два слоя.
Первый — объективная проверка передачи знаний. Для каждого примера создают пять тестовых вопросов с вариантами ответов. Затем визуально-языковая модель в роли зрителя смотрит сгенерированное видео, читает расшифровку речи и отвечает на эти вопросы. Так измеряют, понял ли гипотетический зритель ключевые идеи.
Второй — субъективная оценка качества подачи. Здесь для каждого режима есть свои метрики. Для одиночной презентации смотрят, отвечает ли видео на запрос, насколько удачно использованы найденные материалы и насколько качественно устроена подача. Для дискуссии добавляются метрики эффективности диалога, распределения ролей между спикерами и естественности разговора. Для интерактива оценивают точность ответа, понятность и полезность для аудитории.
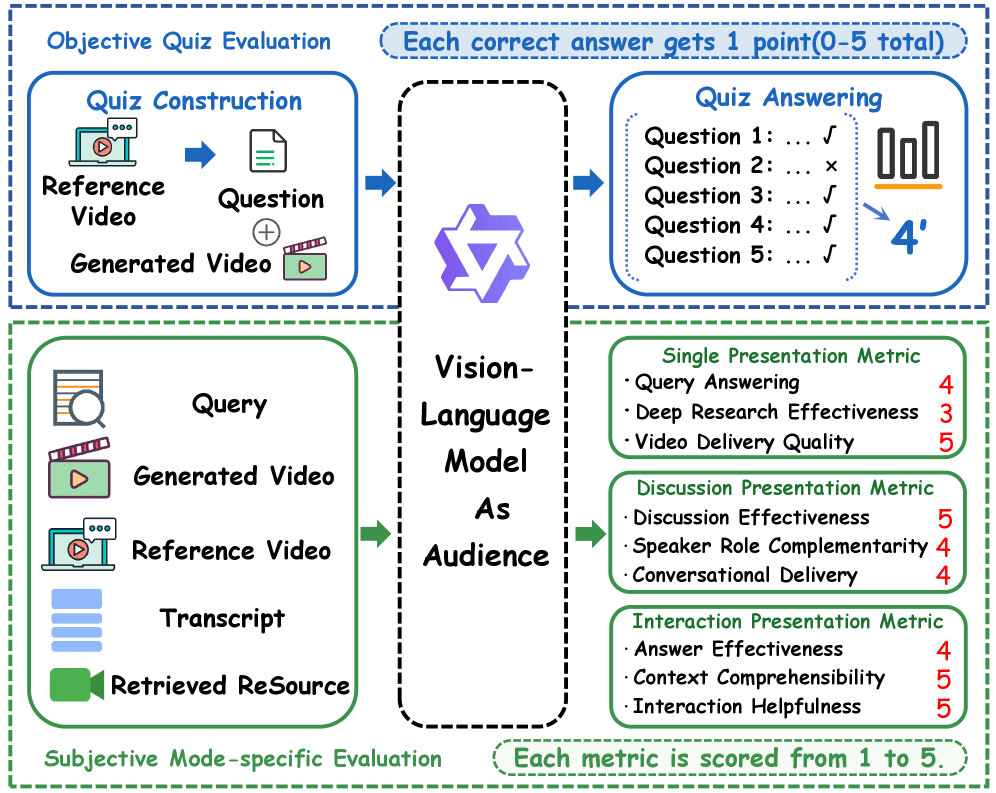
Конечно, у такого подхода есть ограничения: оценщиком снова выступает модель, а не человек. Но для раннего этапа развития направления это всё же лучше, чем вообще не иметь систематической проверки.
Что получилось в экспериментах
Результаты у PresentAgent-2 выглядят неожиданно сильными. На тестах по передаче знаний система набирает около 4.8 из 5 почти во всех режимах. Причём это сопоставимо, а местами и чуть выше, чем у человеческих эталонных видео в том же протоколе. Субъективные оценки тоже высокие — примерно в диапазоне 4.3–4.5 из 5.
Здесь важно не переоценить цифры. Это не значит, что машина уже лучше человека как презентатор. Скорее это означает, что в рамках их бенчмарка система стабильно строит содержательные и внятные ролики, которые хорошо покрывают запрос и не разваливаются по структуре.
Особенно интересен разброс по моделям-основам. Лучшие результаты показывает версия на Qwen3.5-VL-Plus, но и Claude, Gemini, GPT, GLM дают близкие показатели. Это косвенно говорит о том, что вклад даёт не только базовая модель, но и сама архитектура процесса: поиск, фильтрация, генерация сценария, компоновка видео.
Ещё один важный вывод приходит из абляций — экспериментов, где из системы убирают отдельные компоненты. Когда агенту оставляют только текстовые материалы и запрещают использовать изображения, GIF и видео, качество заметно падает. Когда динамические медиа превращают в статичные кадры, результат тоже становится хуже. И когда режим «дискуссия» делают примитивно — просто разрезают монолог на реплики двух голосов, — качество диалога проседает ещё сильнее.
Это, пожалуй, один из самых ценных практических выводов статьи: мультимодальность и форма подачи здесь не косметика, а рабочая часть объяснения. Нельзя просто взять текстовый конспект, озвучить его двумя голосами и назвать это хорошей презентацией.
Что нового по сравнению с предыдущими системами
Авторы прямо сравнивают свой подход с работами, которые генерируют постеры, слайды или видео из научных статей. На их фоне PresentAgent-2 выделяется в трёх местах.
Во-первых, он работает не от документа, а от открытого запроса. Это делает систему ближе к реальному использованию.
Во-вторых, он изначально проектируется как мультимодальный агент. Здесь изображения, анимации и видео встроены в процесс не как украшение, а как источник объяснения.
В-третьих, система охватывает сразу три режима презентации в общей рамке. Обычно работы фокусируются на одном формате — например, только на слайдах или только на закадровом рассказе. Здесь авторы показывают, что одна и та же исследовательская основа может поддерживать одиночное выступление, дискуссию и ответы на вопросы.
Это хорошо ложится в более широкий тренд: ИИ всё чаще рассматривают не как генератор одного артефакта, а как систему, которая умеет искать, собирать, структурировать и объяснять.
Где у работы слабые места
При всей эффектности статья честно оставляет несколько открытых вопросов.
Первый — зависимость от качества найденных источников. Если по теме мало хороших материалов, особенно мультимодальных, то и презентация будет слабее. Агент здесь не создаёт знание с нуля, а сильно опирается на внешнюю информационную среду.
Второй — каскад ошибок. Если на этапе поиска выбраны неудачные страницы, это испортит и слайды, и сценарий, и ответы в интерактивном режиме. Чем длиннее цепочка, тем больше риск, что небольшая ошибка наверху станет заметной проблемой в финальном видео.
Третий — скромный размер бенчмарка. Шестьдесят примеров для новой постановки задачи — разумный старт, но пока явно недостаточно, чтобы делать очень широкие выводы. Особенно если речь пойдёт о областях с высокой ценой ошибки: медицина, право, инженерия.
И наконец, оценка через визуально-языковую модель как «судью» — это компромисс, а не идеал. Для презентаций человеческое восприятие критично: важны темп, ясность, чувство перегруженности, уместность визуальных материалов. Машинная оценка часть этого видит, но не всё.
Итоги
PresentAgent-2 — это интересный и своевременный шаг от автоматической сборки слайдов к автоматическому объяснению темы в формате полноценной презентации. Работа важна не потому, что показывает ещё один красивый интерфейс, а потому что предлагает новую постановку задачи: не «сделай презентацию из документа», а «разберись в запросе, найди материалы и объясни тему в подходящем формате».
Сильные стороны статьи — продуманная архитектура, акцент на мультимодальных источниках, поддержка нескольких режимов подачи и собственный бенчмарк с довольно осмысленной схемой оценки. Особенно убедительно выглядит идея, что хорошая презентация — это не только корректные факты, но и структура, визуальные подтверждения, динамика и форма общения с аудиторией.
До универсального ИИ-лектора ещё далеко. Но PresentAgent-2 хорошо показывает, в каком направлении всё движется: модели становятся не просто генераторами текста или картинок, а агентами коммуникации, которые умеют искать, собирать и доносить знания. И если этот класс систем действительно созреет, то изменится не только создание презентаций, но и сам способ, которым мы учим, объясняем и распространяем сложные идеи.
Читайте также
 Как графы знаний учат LLM меньше галлюцинировать
 Как ИИ-соавтор для математиков решает открытые задачи
 Как агентам делегировать задачи без потери контроля
 Синтетические компьютеры учат агентов работать неделями
 Что на самом деле делает мультиагентные системы умнее
 Почему агенты хуже учатся на длинных задачах
 Для чего нужна рекурсивная мультиагентная система
 Как построить компанию из одного человека и ИИ-агентов
 Модели мира для агентов нового поколения
 Разработка игр стала новым бенчмарком для ИИ-агентов
 Архитектура общей памяти агентов для программирования
 Как ИИ-агенты учатся помнить через окружающий мир
 Когда у ИИ-агента несколько пользователей
 Двунаправленная память: как основа эволюции агентов, которые помнят прошлые шаги
 Атомарные навыки: как улучшить агентов для программирования на 18.7%
 Когда агент — это граф: как устроена оптимизация процессов на лету
 ИИ не может запустить стартап — и вот почему
 Ваша LLM умнее, чем кажется — вы просто используете ее неправильно
 ИИ как коллективный разум: куда ведёт эпоха агентных систем
 Всё, что нужно знать об обучении агентов простыми словами
ИИ-обзоры статей
Каждый день читаем свежие статьи по ИИ и пересказываем главное человеческим языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram