Когда память важнее очередного промта
ИИ-агенты уже умеют искать в сети, писать код, работать с файлами и решать многошаговые задачи. Но есть старая проблема: они плохо накапливают опыт. Агент провалил задачу, кто-то посмотрел логи, поправил навык, прогнал ещё раз — и часть полезных наблюдений снова растворилась в истории итераций. В следующем цикле система часто учится почти заново.
Работа WikiSkill от Google Research предлагает простую мысль: если агент чему-то научился на своих ошибках, это знание надо хранить отдельно и системно. Не только в виде текущего навыка, но и в виде постоянной базы знаний, куда складываются повторяющиеся паттерны, причины провалов и рабочие приёмы. Такой «вики-слой» живёт дольше, чем очередная правка навыка, и становится опорой для следующих обновлений навыков.
Если вы строите ИИ-агентов, вы быстро упираетесь в другой вопрос: умеет ли система улучшать саму себя предсказуемо. WikiSkill как раз про это: как превратить разрозненный опыт запуска агента в воспроизводимую процедуру улучшения.
Что такое WikiSkill
В основе WikiSkill лежит разделение рабочего пространства агента на три слоя.
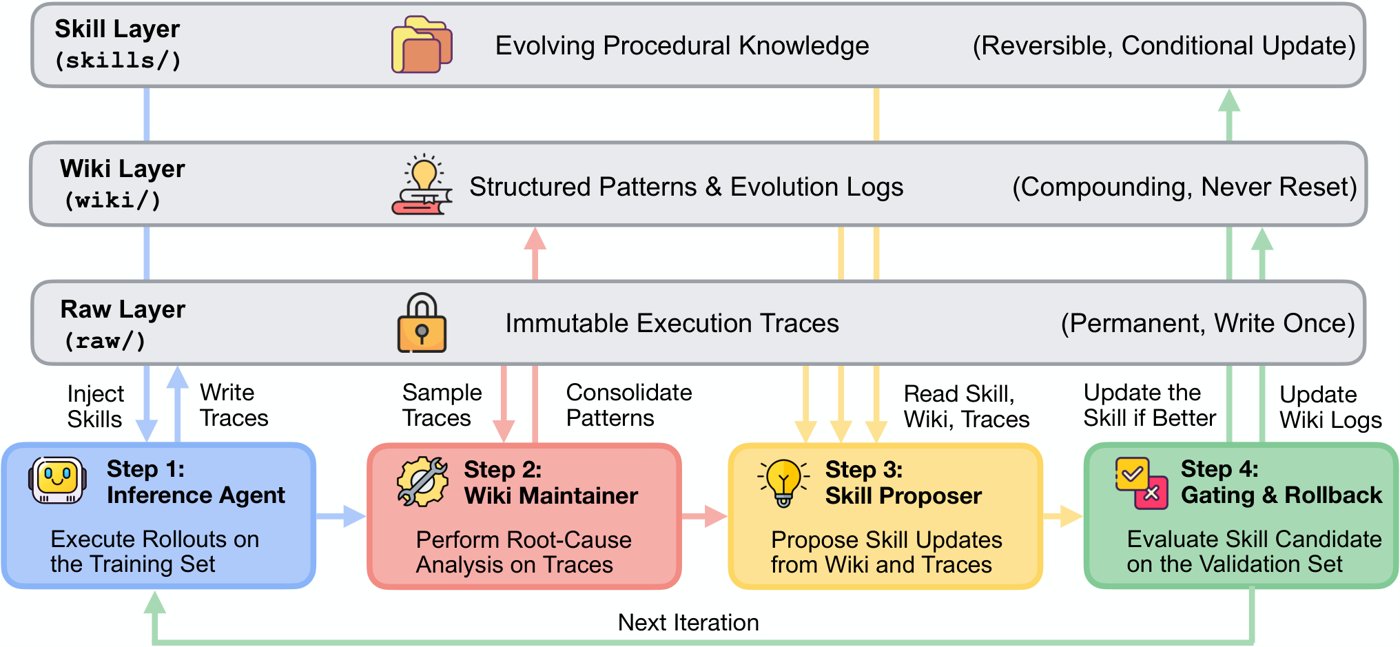
Схема WikiSkill: сырые логи, постоянная база знаний и активные навыки работают как отдельные слои одного пайплайна.
Первый слой — сырые следы выполнения. Это полные логи того, что агент делал: какие шаги предпринимал, какими инструментами пользовался, где ошибся, где сработал правильно.
Второй слой — вики. Это уже не лог, а собранное знание: типичные сбои, успешные стратегии, журнал прошлых изменений и история того, какие правки навыков были приняты или отклонены.
Третий слой — навыки. То есть исполняемые инструкции для агента: что делать в похожих ситуациях, какие шаги предпринимать, чего избегать.
Ключевая идея тут в том, что навык и знание разведены. Навык можно откатить, если он ухудшил качество. А вот вики сохраняется и продолжает накапливать опыт. Значит, даже неудачная попытка не пропадает зря.
Коротко механика выглядит так:
🟠 Агент решает тренировочные задачи с текущими навыками и оставляет логи.
🟠 Отдельный модуль разбирает логи и записывает в вики повторяющиеся паттерны: что проваливается, что помогает, какие идеи уже пробовали.
🟠 Предлагатель навыков читает вики, смотрит свежие логи и вносит одну атомарную правку: создать новый навык или поправить существующий.
🟠 Проверка на валидации решает, оставить правку или откатить её.
Во время тренировочных прогонов сам агент не читает вики. Авторы отдельно показали, что если дать агенту доступ к вики слишком рано, он начнёт опираться на неё при решении задач, а не превращать это знание в устойчивый навык. В итоге следы выполнения становятся менее полезны для дальнейшего улучшения.
Почему обычной эволюции навыков уже мало
Последние работы по эволюции навыков тоже строятся вокруг цикла «запуск → анализ → правка → проверка». Но у них есть общий изъян: знание остаётся размазанным по истории оптимизации. Где-то в отклонённой правке, где-то в логе, где-то в частичном обновлении инструкции.
WikiSkill добавляет между логами и навыками отдельный слой памяти. Из-за этого система начинает делать то, что люди давно считают нормой в инженерии: вести не только итоговую инструкцию, но и журнал причин, исключений и повторяющихся ошибок.
Это особенно полезно для длинных и инструментальных задач, где провал редко объясняется одной строкой. Например:
🟣 агент зацикливается в текстовой среде и повторяет одно и то же действие;
🟣 агент в задаче по таблицам пишет короткие обходные команды вместо надёжного скрипта;
🟣 агент в длинных документах начинает читать всё подряд вместо точечного поиска;
🟣 агент повторно предлагает идею, которую уже пробовали и отклонили.
Обычный навык может зафиксировать только итог: «делай так». Вики фиксирует ещё и почему возникла правка, какие альтернативы не сработали и какие симптомы повторяются от итерации к итерации.
Как это проверяли
Авторы прогнали WikiSkill на пяти бенчмарках и пяти моделях.
По задачам набор получился разношёрстный:
🟠 математика — LiveMath;
🟠 поиск в сети — SealQA;
🟠 работа с таблицами — SpreadsheetBench;
🟠 вопросы по длинным документам — OfficeQA;
🟠 интерактивная среда — ALFWorld.
По моделям тоже без перекоса в одну сторону: Qwen-3.5 4B, Qwen-3.5 9B, Qwen-3.6 27B, Gemma-4 31B и Gemini-3.5-Flash.
Сравнивали с тремя системами эволюции навыков: EvoSkill, Trace2Skill и SkillOpt, плюс с базовым вариантом без навыков вообще.
Авторы запускали полный цикл эволюции по три раза для каждого метода, чтобы сгладить шум маленьких валидационных выборок. Когда валидация маленькая, один удачный или неудачный пример может слишком сильно влиять на решение «принимать правку или нет».
Что получилось
WikiSkill стабильно выигрывает и у режима без навыков, и у других методов эволюции навыков.
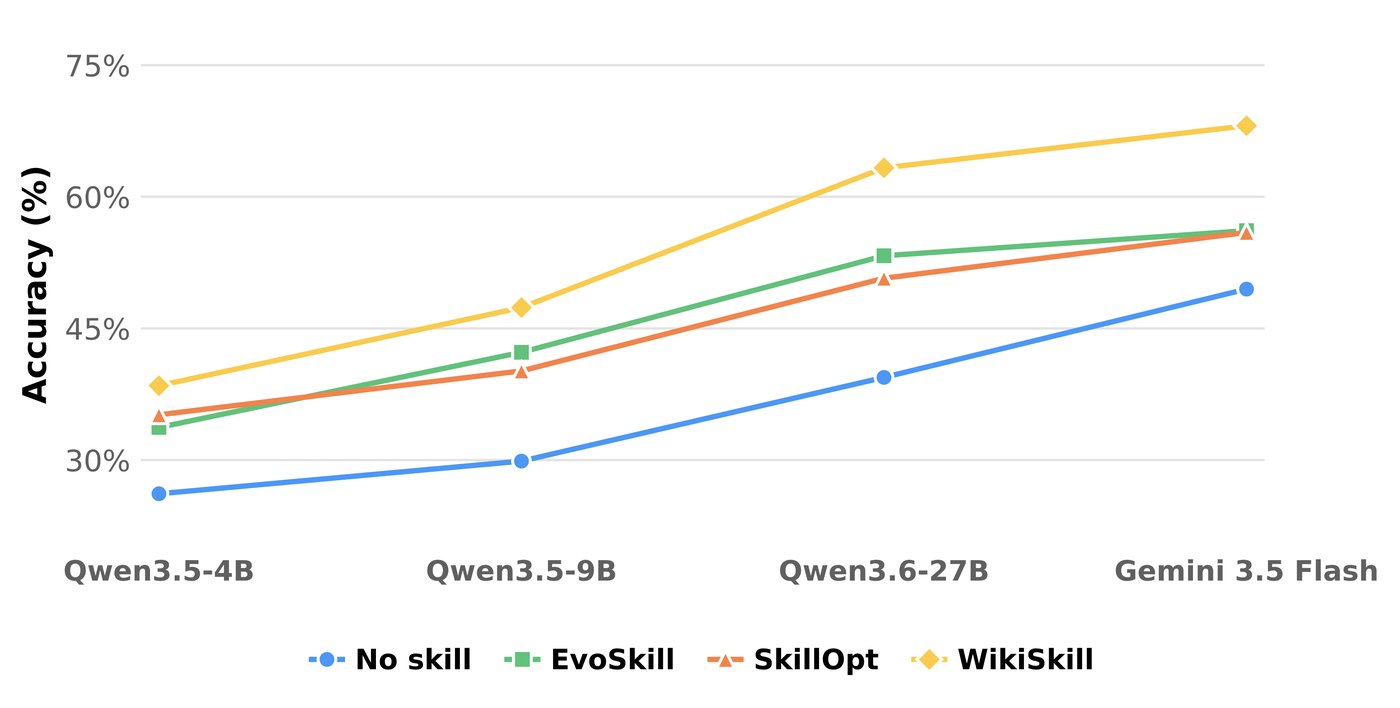
WikiSkill обходит базовый режим без навыков и другие методы эволюции навыков; отрыв растёт на более сильных моделях.
Средняя точность по пяти задачам выросла так:
🟣 Qwen-3.5-4B: с 26.2 до 38.5
🟣 Qwen-3.5-9B: с 29.9 до 47.4
🟣 Qwen-3.6-27B: с 39.4 до 63.3
🟣 Gemma-4-31B: с 41.3 до 54.9
🟣 Gemini-3.5-Flash: с 49.5 до 68.1
Коротко по цифрам:
🟠 чем сильнее модель, тем больше она выигрывает от эволюции навыков;
🟠 внутри семейства Qwen прирост составил 12.3, 17.5 и 23.9 процентного пункта для моделей 4B, 9B и 27B соответственно;
🟠 масштаб модели и эволюция навыков складываются, а не заменяют друг друга.
Часто кажется, что навыки нужны скорее слабым моделям как костыль. Здесь видно другое: большие модели лучше извлекают пользу из хороших процедурных инструкций.
Ещё несколько наблюдений:
🟠 маленькая модель с навыками может обогнать большую без навыков: Qwen-3.5-9B с WikiSkill набрала 47.4, а Qwen-3.6-27B без навыков — 39.4;
🟠 на задачах с таблицами прирост особенно заметен: у Qwen-3.6-27B результат вырос с 40.8 до 81.7;
🟠 на математике улучшение устойчиво у всех моделей: например, Gemini-3.5-Flash выросла с 33.0 до 72.6;
🟠 не все задачи одинаково поддаются улучшению: на OfficeQA приросты меньше, а у маленькой Qwen-3.5-4B даже есть небольшое ухудшение.
Последний пункт тоже важен. Длинные документы требуют не просто хорошего навыка, но и способности модели дисциплинированно его исполнять. Маленькая модель может получить разумную инструкцию и всё равно не следовать ей до конца.
Навыки можно переносить между моделями
Один из самых интересных результатов — навыки переносятся между моделями, иногда лучше, чем работают у автора этих же навыков.
Например, навык, который выработала Qwen-3.6-27B, поднял Qwen-3.5-9B на SpreadsheetBench до 50.5. Для сравнения: без навыков у той было 24.3, а со своими собственными навыками — 33.6.
Есть и обратные случаи: навыки, найденные маленькой моделью, помогали более крупной. Это говорит о важной вещи: обнаружить полезную процедуру и качественно исполнить её — разные способности.
Но перенос не всегда безопасен. Авторы показывают и отрицательный перенос. К примеру, навыки от Qwen-3.5-4B на задачах по таблицам ухудшили Gemini-3.5-Flash с 50.5 до 18.1.
Почему так бывает:
🟣 маленькая модель записывает слишком низкоуровневые обходные приёмы;
🟣 сильная модель из-за этого теряет свободу выбрать более общий и надёжный путь;
🟣 фрагментированные инструкции приводят к лишним вызовам инструментов;
🟣 у модели заканчивается бюджет шагов до завершения задачи.
Коротко:
🟠 навык — переносимый артефакт, но не универсальный;
🟠 перенос между моделями надо проверять отдельно по типам задач;
🟠 качество навыка зависит не только от того, кто его исполняет, но и от того, кто его нашёл.
Зачем здесь нужен именно вики-слой
Авторы отдельно проверили, что именно даёт постоянная база знаний, а не просто ещё один этап анализа.
Когда у модуля, который предлагает новые навыки, нет доступа к вики, средний результат на Gemini-3.5-Flash составляет 48.7. Когда доступ есть, метрика поднимается до 63.7. Разница — 15 процентных пунктов.
То есть дело в том, что система помнит контекст прошлых попыток.
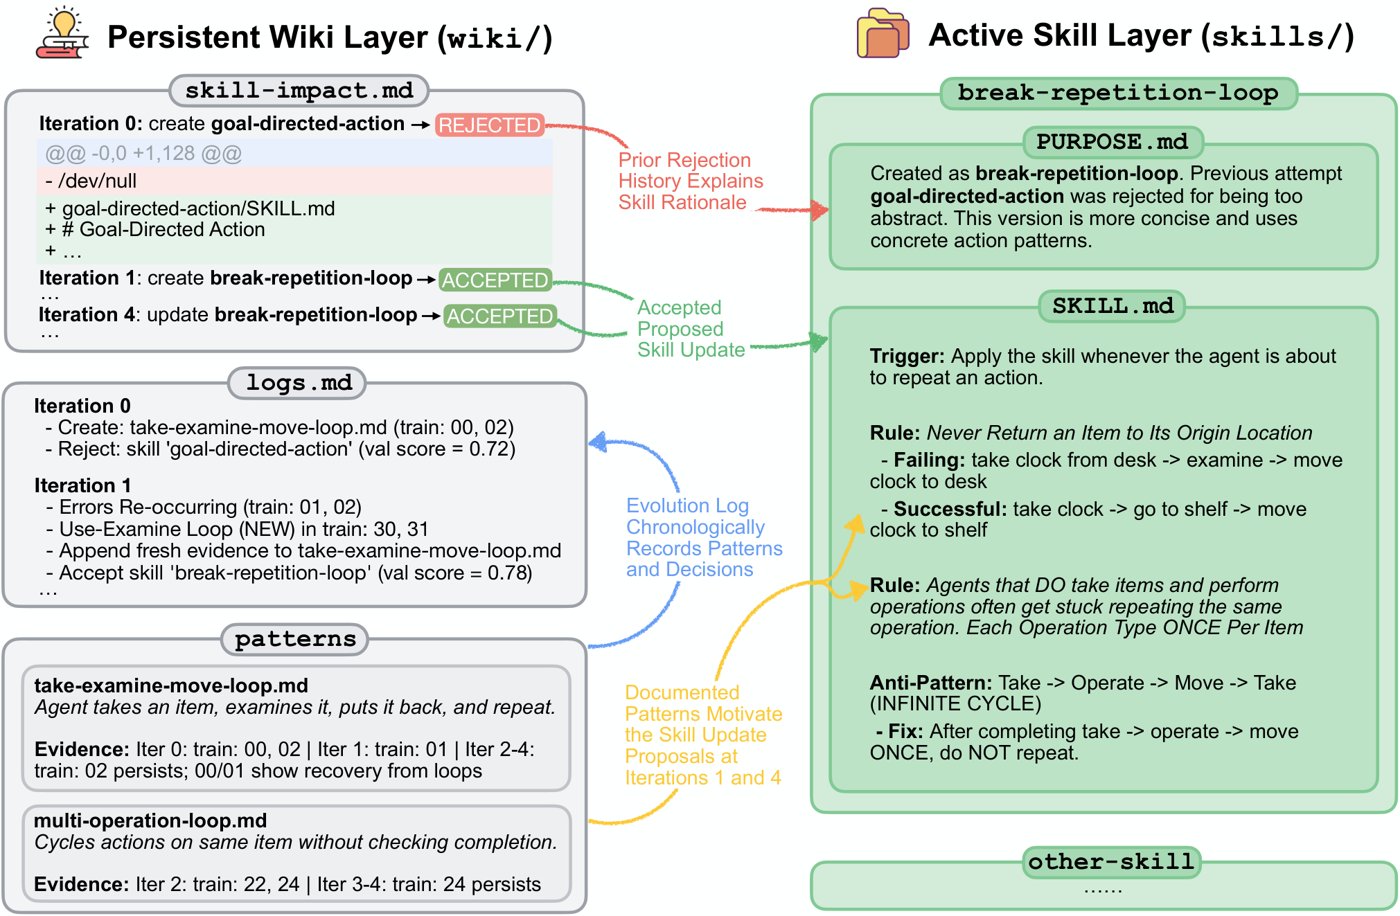
Пример из ALFWorld: отклонённая правка не исчезает, а остаётся в вики и помогает сформулировать следующую, уже успешную версию навыка.
Особенно нагляден пример из ALFWorld. Сначала система замечает цикл действий, предлагает одно исправление, оно не проходит валидацию и откатывается. Но запись о неудачной правке остаётся в вики. На следующей итерации модуль видит: этот путь уже пробовали, он не помог. И формулирует другой, более конкретный навык — уже с успешным правилом поведения.
Журнал здесь становится рабочим знанием для следующего шага.
Что это меняет на практике
WikiSkill сдвигает разговор об ИИ-агентах в полезную сторону: как организовать накопление процедурного знания вне весов модели.
Для практики это даёт несколько выводов:
🟠 не всё надо дообучать — часть улучшений удобнее хранить как внешние навыки и базу знаний;
🟠 память об ошибках должна жить дольше одной итерации;
🟠 сильные модели особенно выигрывают от хорошей обвязки;
🟠 перенос навыков между моделями реален, но его нужно проверять по типам задач;
🟠 разделение “сырые логи → знание → навык” полезнее, чем сваливать всё в один промт или один файл инструкции.
Есть и ограничения. В работе навыки просто целиком подмешиваются в системный промт, так что вопрос выбора нужного навыка из большой библиотеки пока остаётся открытым. Валидация жёсткая: принимаются только те правки, которые сразу улучшают результат. А сама вики со временем может разрастись и потребовать чистки.
Вывод
WikiSkill показывает простую вещь: если вы хотите, чтобы ИИ-агент улучшался по итерациям, одной истории запусков мало. Нужна постоянная база знаний, которая хранит паттерны ошибок, рабочие процедуры и память о неудачных попытках.
Из результатов видно три главные мысли:
🟣 эволюция навыков работает лучше, когда знание отделено от самих навыков;
🟣 более сильные модели получают от таких навыков ещё больше пользы;
🟣 навыки можно переносить между моделями, но перенос зависит от того, насколько общими оказались процедуры.
Если коротко, будущее ИИ-агентов похоже не только на гонку за более крупными моделями. Оно похоже ещё и на инженерную дисциплину вокруг них: логи, память, аккуратные правки, проверка гипотез и обвязка, которая умеет не забывать.
Читайте также
 Автоматическая отладка улучшила ИИ-агентов на 10%
 Можно ли научить ИИ-агента делать покупки как человек
 Как ИИ-агент восстанавливается после ошибок и меняет план
 Как графы помогают ИИ-агентам работать вместе
 Как ИИ-агент переносит навыки между разными задачами
 Как сильная модель улучшает слабую без переобучения
 Что если агенты смогут менять среду и саму эволюцию
 Зачем агенту понимать причины поступков человека
 ИИ-агенты для генерации кода решили лишь 41% задач в новом тесте
 Как миллионы виртуальных пользователей помогают заменить дорогие тесты на людях
 Почему лучший ИИ собрал ответ из разных данных с точностью лишь 66%
 Почему для продвижения бренда в ответах ИИ нужны сторонние сайты
 Как проверить, способен ли ИИ вести торги целый год
 Игра в шпиона помогает ИИ улучшать тексты и рассуждения
 Как один ИИ-агент работает в телефоне, браузере и на компьютере
 Что помогает ИИ лучше писать код с нуля
 ИИ-агенты соблюдают правила компании лишь в 36% случаев
 Холст превращает разрозненные идеи в понятный для ИИ проект
 ИИ-агентов научили управлять памятью во время долгих задач
 Как один разбор ИИ-агента исправил втрое больше задач, чем прежние методы
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram