Когда LLM дают магазин на год
Большинство бенчмарков для ИИ-агентов проверяют короткую дистанцию. Исправить баг. Найти ответ. Пройти набор шагов. Даже если шагов много, задача часто сводится к одному финальному результату.
E-Commerce Bench смотрит на другую проблему: что будет, если дать модели не задание на 20 минут, а бизнес на 365 дней. С деньгами, складом, возвратами, переговорами, мошенниками, сезонностью и кассовыми разрывами.
Звучит почти как симулятор. По сути это проверка того, что сегодня волнует всех, кто строит ИИ-агентов: умеет ли модель держать линию на длинном горизонте, учиться по ходу дела и не проваливать задачу из-за собственной забывчивости, суеты или плохих решений в начале пути.
В новой статье команда Qwen и исследователи из HKUST представили открытый бенчмарк, где 18 передовых моделей управляют интернет-магазинами в течение целого года. Итог измеряют не только деньгами. Смотрят ещё на переговоры, устойчивость к мошенничеству, управление ликвидностью, эффективность, исполнение операций и способность улучшать решения по мере накопления опыта.
И тут начинается самое интересное: модель, которая зарабатывает больше всех, вовсе не лучшая по остальным качествам.
Что такое E-Commerce Bench
Идея простая. Модели выдают стартовый капитал в 100 тысяч юаней и доступ к инструментам продавца на маркетплейсе. Дальше агент сам решает, что делать:
🟠 открыть до четырёх магазинов разных типов
🟣 изучать категории и спрос
🟠 искать поставщиков
🟣 торговаться по цене
🟠 закупать товар
🟣 выставлять его в магазинах
🟠 менять цены
🟣 отправлять заказы
🟠 обрабатывать возвраты
🟣 выводить деньги из кошелька платформы в банк
Это важно, потому что задача здесь не распадается на независимые мини-задачи. Если вы в январе купили не тот товар, ошиблись с объёмом или повелись на мошенника, последствия тянутся месяцами. Склад копит издержки. Деньги уходят сразу, а выручка приходит с задержкой. Репутация магазина влияет на спрос. Поставщик, у которого вы удачно выбили цену, может исчезнуть позже.
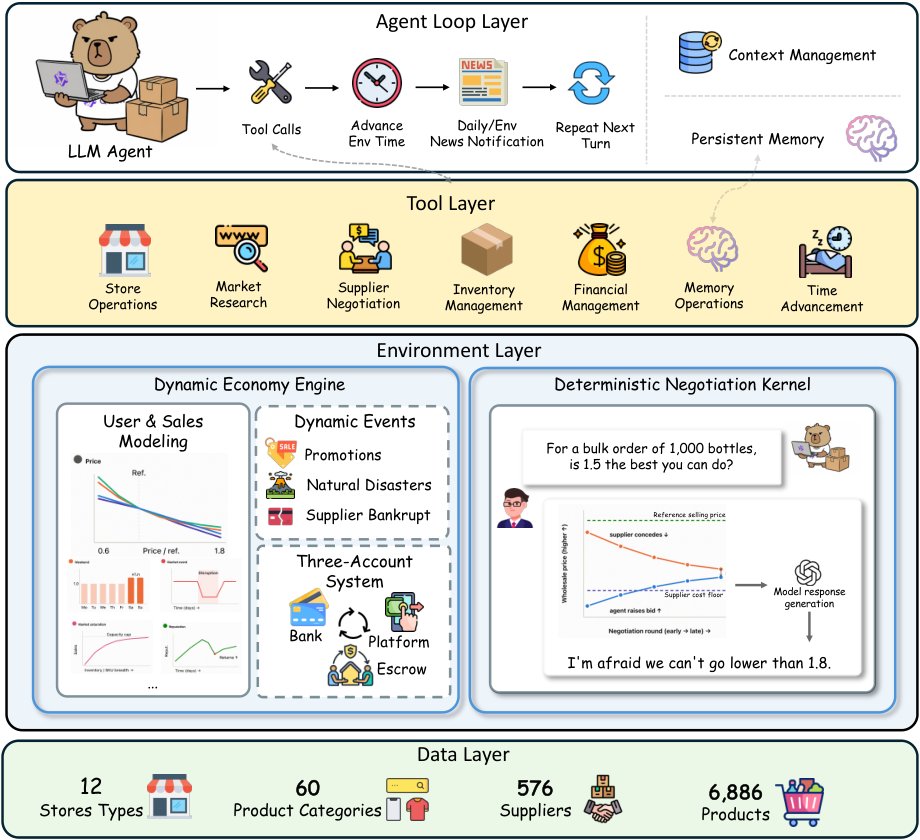
Схема E-Commerce Bench: агент работает через обвязку и 18 инструментов, а под ними живёт детерминированная модель экономики и переговоров.
У бенчмарка четыре слоя. Сверху — обвязка агента: цикл ходов, работа с контекстом и постоянная память. Ниже — 18 инструментов. Под ними — детерминированная среда, где отдельно живут продажи, экономика и переговоры. Внизу — данные, собранные на основе реальной платформы электронной торговли.
Ключевой момент здесь — слово детерминированная. Авторы специально убрали как можно больше шума. Если два агента совершают одинаковые действия, они получают одинаковый результат. Это редкость для сложных бенчмарков для ИИ-агентов, где всё часто плывёт из-за случайных ответов второй стороны или нестабильной симуляции.
Почему это важно
Сейчас многие бенчмарки для агентов по сути проверяют, может ли модель довести до конца один длинный сценарий. E-Commerce Bench проверяет другое: может ли модель месяцами принимать связанные решения в меняющейся среде.
Разница большая.
Если вы строите ИИ-агентов для реальной работы, вас интересует не только способность вызвать инструмент или написать убедительный ответ. Вас интересует вот что:
🟠 помнит ли агент, какую цену уже выбил у поставщика
🟣 замечает ли он, что деньги зависли в кошельке платформы, пока банк уходит в минус
🟠 умеет ли он отказаться от подозрительного поставщика
🟣 не тратит ли он половину года на повтор одних и тех же запросов
🟠 учится ли он на своих прошлых сделках
🟣 выдерживает ли стратегию, когда контекст давно переполнен
Именно на таких вещах длинные задачи обычно проваливаются. Не на одном большом неверном ответе, а на цепочке мелких просчётов.
Как устроена среда
Внутри бенчмарка довольно жёсткая экономика.
У агента есть три денежных контура:
🟠 банковский счёт — с него списываются закупки, операционные расходы, хранение и доставка
🟣 эскроу — туда попадает выручка после отгрузки
🟠 кошелёк платформы — туда деньги доходят позже, и только потом их можно вывести в банк
Это значит, что прибыльный бизнес всё равно может обанкротиться, если агент плохо управляет ликвидностью. Продал много — не значит, что у вас есть живые деньги сегодня.
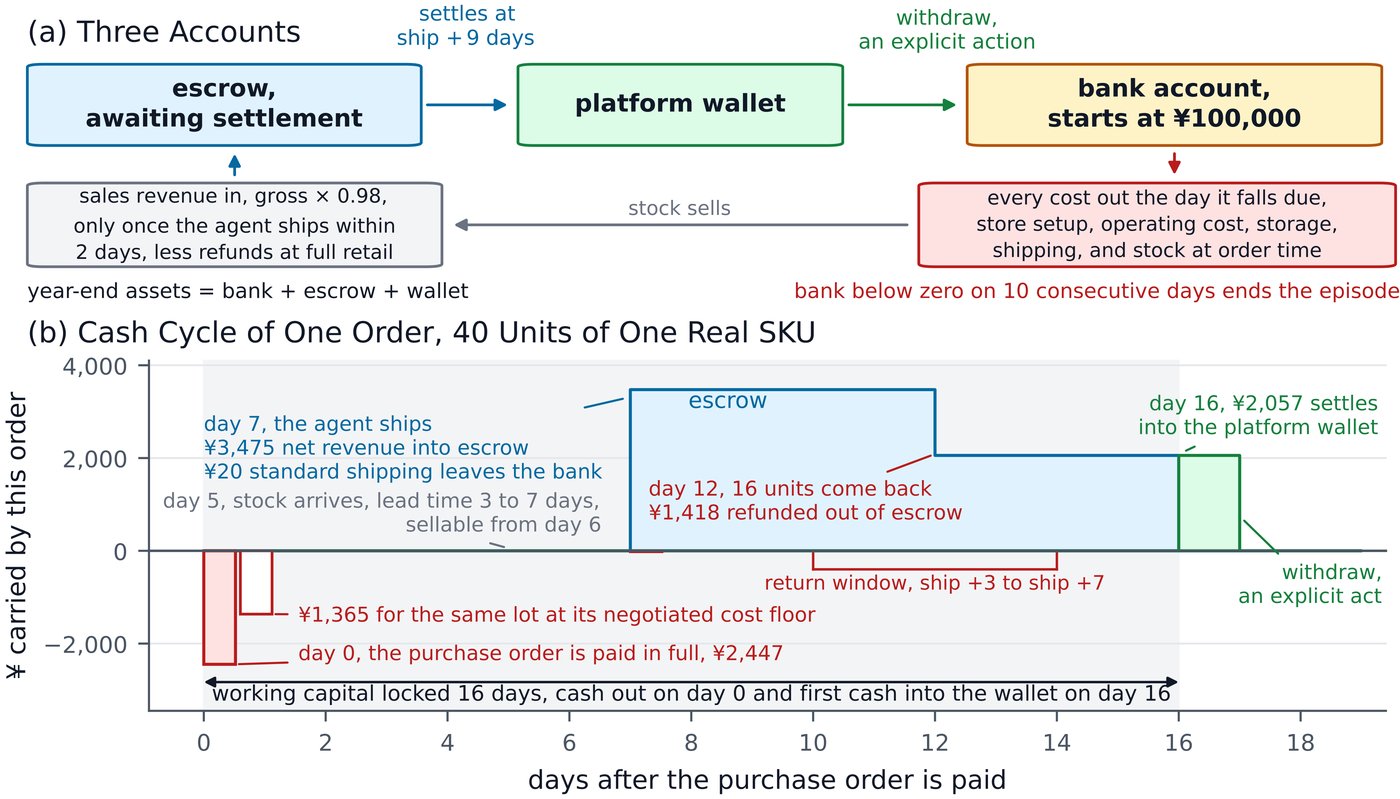
Деньги в симуляции идут по трём счетам с задержкой: расходы списываются сразу, а выручка доходит до банка только через эскроу и кошелёк платформы.
Есть и другие реалистичные детали:
🟠 спрос зависит от цены, сезона, дня недели, акций, событий и репутации магазина
🟣 товар нужно успеть отправить за два дня, иначе заказ отменится
🟠 возвраты зависят от категории, цены, скорости доставки и качества партии
🟣 хранение на складе дорожает со временем
🟠 у поставщиков есть скрытый порог цены, ниже которого они не согласятся
🟣 около четверти поставщиков мошенничают
Отдельно устроены переговоры. Во многих похожих симуляциях вторую сторону тоже играет LLM, и тогда всё разваливается: слишком много случайности, слишком легко уговорить контрагента на неестественное решение. Здесь экономика переговоров задаётся правилами, а LLM только озвучивает реплики поставщика. Цена, уступка, согласие или отказ определяются не словесной магией, а детерминированным ядром.
Это делает сравнение моделей чище.
Что проверяли у моделей
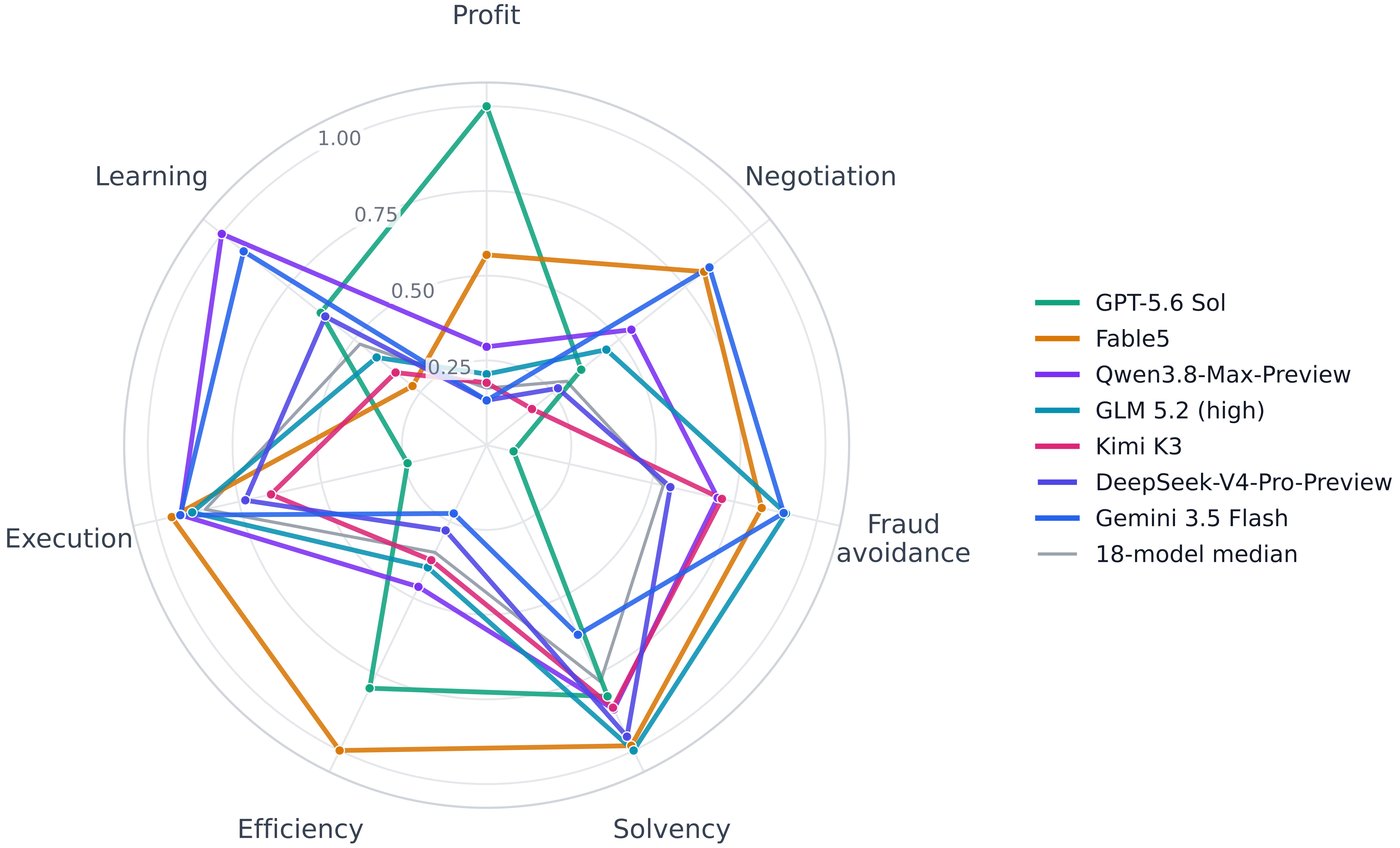
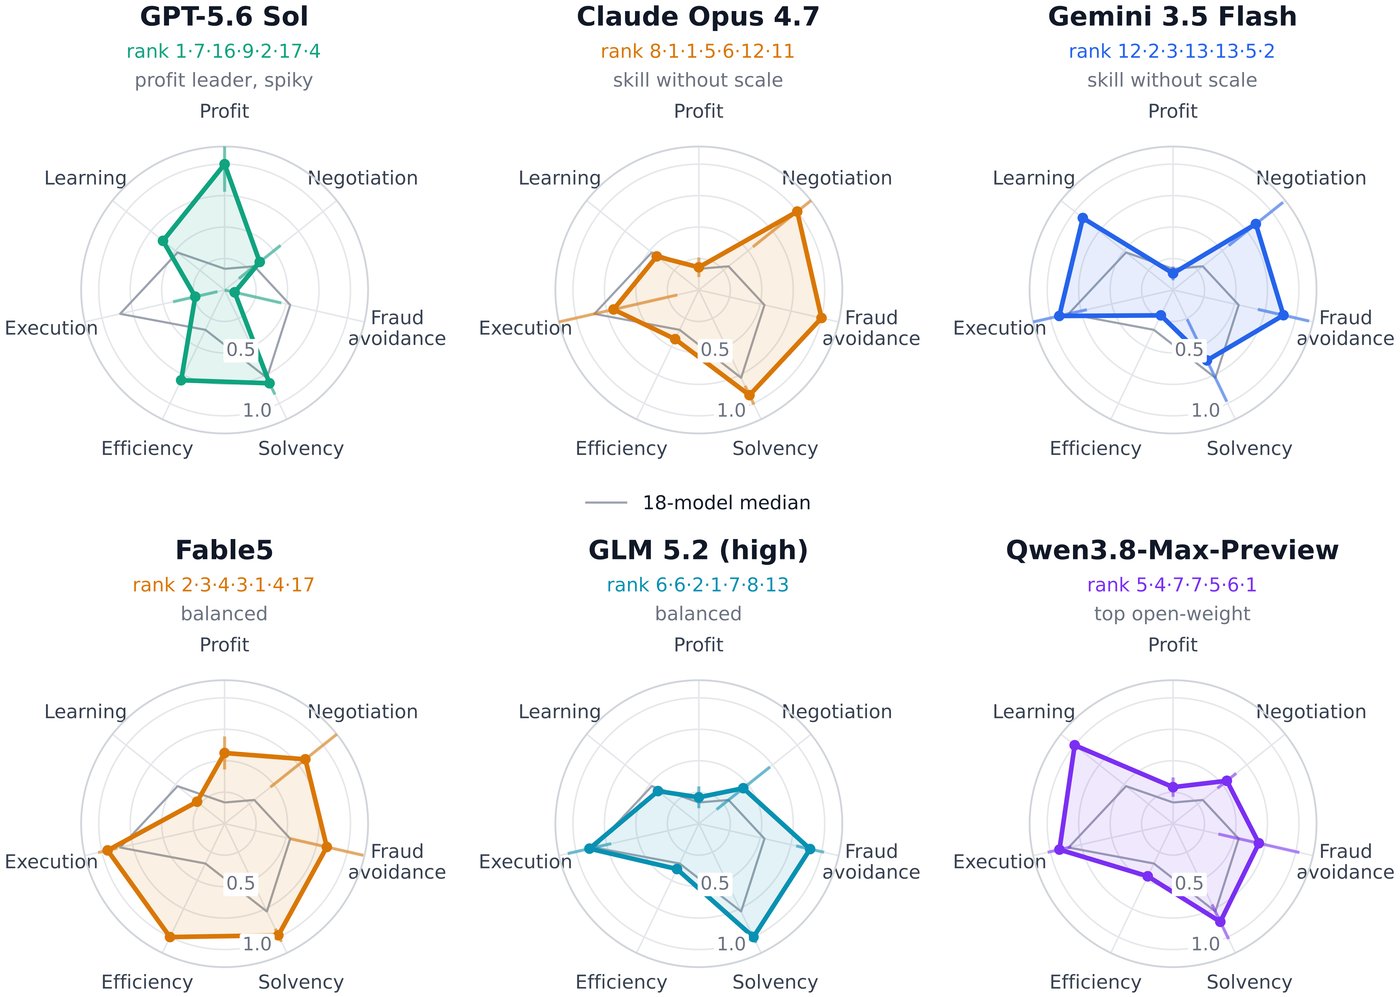
Авторы не стали сводить всё к одному числу. Кроме итоговых активов, они ввели ещё шесть осей оценки:
🟠 качество переговоров — насколько сильно модель умеет сбивать цену у честных поставщиков
🟣 защита от мошенничества — какая доля закупок ушла мошенникам
🟠 ликвидность и устойчивость — насколько глубоко агент проседал по активам и не уходил ли в банкротство
🟣 операционная эффективность — сколько прибыли принёс один вызов инструмента
🟠 исполнение операций — как агент управлял возвратами и отгрузками
🟣 обучение на длинном горизонте — использовал ли агент опыт прошлых закупок, чтобы со временем покупать дешевле
Вот здесь статья даёт важный результат: универсального победителя нет.
Коротко:
🟠 GPT-5.6 Sol — лидер по деньгам
🟣 Qwen3.8-Max-Preview — лучшая среди открытых моделей
🟠 лидер по прибыли не лидер по защите от мошенничества
Итоговые активы 18 моделей к концу года: разброс огромный, а часть эпизодов заканчивается банкротством.
Лидером по деньгам стал GPT-5.6 Sol. Он в среднем превратил стартовые 100 тысяч юаней в 1,43 млн. Это примерно 14,3x от начального капитала.
Но рядом с этим числом сразу идёт неприятное уточнение: по защите от мошенничества модель заняла 16 место из 18. То есть зарабатывала много, но заметную долю денег всё равно отдавала плохим поставщикам.
Среди открытых моделей лучшей стала Qwen3.8-Max-Preview. Она дошла до 416 тысяч юаней, то есть примерно до 4,2x от старта. Это не уровень лидера общего зачёта, но лучший результат в открытом сегменте.
Главные результаты
Если сжать статью до нескольких тезисов, картина такая:
🟠 Разрыв между моделями огромный. Между лучшей и худшей по итоговым активам — разница более чем в тысячу раз.
🟣 Высокая прибыль не равна надёжности. Лидер по деньгам может быть слабым в защите от мошенничества или в эффективности.
🟠 Четыре модели частично банкротились. Даже сильные семейства моделей не застрахованы от кассового провала.
🟣 Почти никто не учится по ходу года. 16 из 18 моделей не показывают явного прогресса в повторных переговорах с тем же поставщиком.
🟠 Память используется слабо. Хотя у агентов есть постоянная память вне окна контекста, большинство почти ей не пользуется.
🟣 Много вызовов инструментов уходит не туда. Основная масса действий — это рутина: отгрузка, переход к следующему дню, вывод денег, публикация товара. На реальное улучшение закупки и цен тратится мало внимания.
Коротко по результатам:
🟠 1,43 млн юаней у лидера
🟣 4 из 18 моделей частично банкротились
🟠 16 из 18 не показали явного обучения на длинном горизонте
Особенно интересен результат по обучению на длинном горизонте. Авторы проверяли, помнит ли модель, по какой цене уже покупала один и тот же товар у того же поставщика. Логика простая: если вы однажды выбили хорошую цену, следующую закупку разумно начинать хотя бы с этого якоря.
На практике почти все модели этого не делают. Они либо забывают прошлые сделки, либо не умеют использовать их в новых переговорах, либо просто не выстраивают такую стратегию.
Исключение — Qwen3.8-Max-Preview. Это единственная модель, которая уверенно показала улучшение по мере года и смогла в среднем давить цену вниз на повторных закупках.
Переговоры на коротком и длинном горизонте: один агент платит больше, чем уже платил раньше, другой постепенно сбивает цену при повторных заказах.
Где модели чаще всего проваливаются
Статья показывает не только итоговые баллы, но и типовые поломки.
Самые частые проблемы такие:
🟠 агент покупает слишком много товара в начале года и потом тонет в складских расходах
🟣 агент соглашается на подозрительных поставщиков и повторно закупается у них
🟠 агент принимает стартовую цену без торга, хотя можно было сбить её ниже
🟣 агент повторяет одни и те же поисковые запросы вместо того, чтобы сохранить выводы в память
🟠 агент забывает выводить деньги из кошелька платформы в банк
🟣 агент почти не меняет цены в течение года, хотя спрос вокруг уже изменился
Один из показательных кейсов — банкротный эпизод у Qwen3.5-Plus. Модель открыла четыре магазина почти сразу, закупила много товара, продажи не успели это переварить, расходы росли, деньги в банк не возвращались достаточно быстро. В итоге всё закончилось минусом уже к маю.
Это напоминание: на длинном горизонте агент проваливает задачу потому, что не держит систему в целом.
Что это говорит о LLM-агентах сегодня
Если вы смотрите на рынок агентных систем, статья даёт довольно ясную картину.
Во-первых, длинный горизонт остаётся слабым местом. Модели уже умеют неплохо выполнять локальные действия: вызвать инструмент, провести отдельные переговоры, открыть магазин, отправить заказ. Но связать всё это в устойчивую годовую стратегию получается редко.
Во-вторых, память и управление состоянием важнее, чем кажется по коротким демкам. Когда история тянется тысячи шагов, агенту нужно не просто знать мир, а хранить полезные рабочие факты: кто мошенничал, где был хороший поставщик, какие цены уже проходили, какие магазины реально окупаются.
В-третьих, одного лидерборда по прибыли мало. Если смотреть только на финальные деньги, вы пропустите половину картины. Один агент богатый, но дырявый по мошенничеству. Другой аккуратный, но медленный. Третий отлично торгуется, но слабо масштабируется.
И наконец, для честной оценки агентных систем нужны воспроизводимые среды. Здесь это особенно видно. Когда экономика и переговоры задаются детерминированно, различия в результате можно связывать с политикой самого агента, а не со случайной удачей.
Вывод
E-Commerce Bench показывает, что длинные многошаговые задачи для ИИ-агентов — это уже вопрос, умеет ли модель месяцами управлять последствиями своих решений.
Главные выводы из статьи такие:
🟠 Лучшая по деньгам модель не оказывается лучшей по всем остальным метрикам.
🟣 Почти все модели плохо используют накопленный опыт на длинном горизонте.
🟠 Ликвидность, память и защита от мошенничества остаются системными проблемами.
🟣 Открытые модели уже конкурентны в части стратегического поведения, но до лидеров по прибыли дистанция ещё большая.
🟠 Следующий прогресс в агентах будет зависеть не только от самой LLM, но и от обвязки: памяти, контроля состояния, правил работы с контекстом и устойчивых процедур принятия решений.
Если вы хотите понять, где у современных ИИ-агентов заканчиваются аккуратные демки и начинается реальная работа в длинной среде, этот бенчмарк даёт один из самых полезных ответов на сегодня.
Читайте также
 Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
 Как ИИ-агент за несколько дней собрал играбельный шутер
 Как граф превращает ошибки ИИ-агента в подсказки
 А что, если ИИ-агенту проще пересоздать библиотеку, чем чинить её?
 Как ИИ-агент превращает научную статью в рабочий код
 Как ИИ-агент делает дизайн красивым и редактируемым
 Как собирать готовые навыки для ИИ-агентов из репозиториев с кодом
 Почему каждому студенту нужен ИИ-репетитор
 Как ИИ-агенты меняют роль разработчика
 ИИ-агент собирает законы физики из видео
 Как опыт превращается в рабочие навыки ИИ-агента
 Автоматическая отладка улучшила ИИ-агентов на 10%
 Можно ли научить ИИ-агента делать покупки как человек
 Как ИИ-агент восстанавливается после ошибок и меняет план
 Как графы помогают ИИ-агентам работать вместе
 Как ИИ-агент переносит навыки между разными задачами
 Как сильная модель улучшает слабую без переобучения
 Что если агенты смогут менять среду и саму эволюцию
 Зачем агенту понимать причины поступков человека
 ИИ-агенты для генерации кода решили лишь 41% задач в новом тесте
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram