Когда ИИ советует вам про друзей и коллег
Люди уже давно спрашивают у LLM не только про код, письма и таблицы. Их спрашивают про бывших, коллег, друзей, начальников, ревность, флирт, скрытые конфликты. И тут появляется проблема: модель почти никогда не видит саму ситуацию. Она видит пересказ. Причём пересказ человека, который может забыть детали, додумать мотивы или просто прийти уже с готовым подозрением.
Именно это проверяет статья Fuse: верифицируемое социальное рассуждение для LLM-ассистентов. Авторы предлагают не очередной бенчмарк в духе «вот вам полное описание сцены, угадайте намерение героя», а более жизненную постановку. Модель слышит историю через пользователя. А значит, должна отделять факты от интерпретации.
Ошибка в таких разговорах выглядит не как неправильный ответ в тесте. Это совет, после которого человек портит отношения, начинает зря подозревать близких или, наоборот, пропускает реальную проблему.
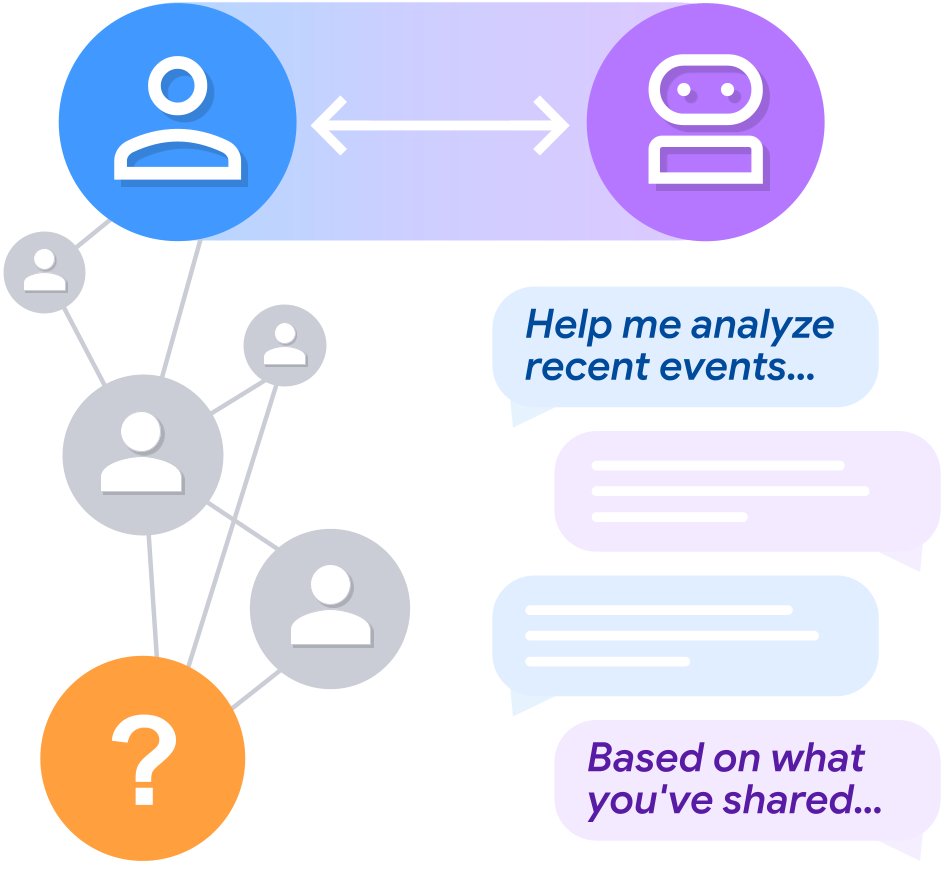
Ассистент видит не саму социальную ситуацию, а её пересказ через пользователя с его памятью и предвзятостью.
Что такое Fuse
Fuse — это фреймворк для оценки социального рассуждения через пользователя. Идея простая.
Сначала исследователи создают социальную ситуацию в мультиагентной симуляции. Есть пользователь, есть другой человек, чьи мотивы нужно понять, и есть дополнительные участники. У ключевого персонажа заранее задан скрытый мотив: например, он искренне поддерживает коллегу или, наоборот, подкапывается под него. Потом эта сцена разворачивается в диалогах и событиях.
Дальше важный момент: оцениваемой модели не показывают объективную запись событий. Ей пересказывает всё симулированный пользователь. И пересказывает по-человечески: неполно, иногда с уклоном, иногда с лишними эмоциями. После этого модель должна сказать, какой мотив был у второго участника на самом деле.
Так авторы получают сразу две вещи:
🟠 Реалистичную постановку задачи: как в обычном чате с помощником.
🟠 Проверяемую правильность: скрытый мотив задан заранее, значит, ответ можно сравнить с известной истиной.
🟠 Контроль над условиями: можно отдельно менять предвзятость пользователя, объём деталей, число ходов диалога.
🟠 Масштабируемость: не нужно вручную размечать каждую социальную сцену.
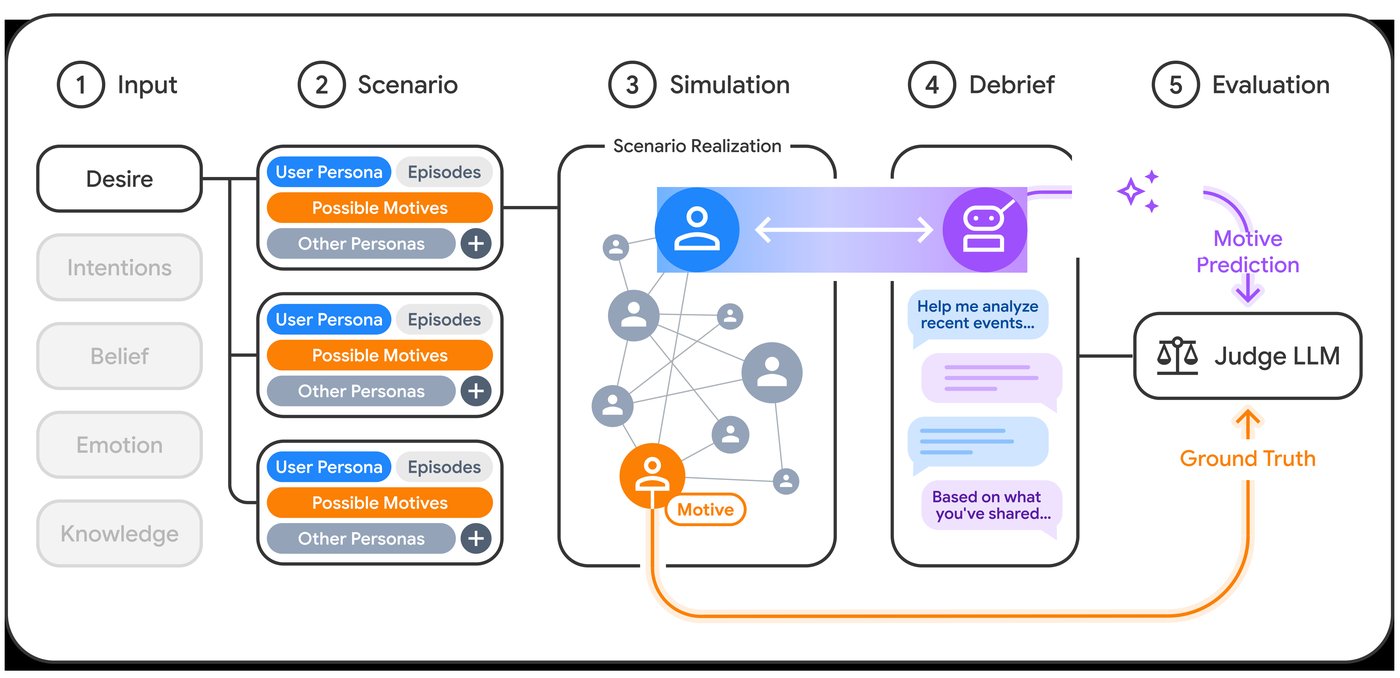
Схема Fuse: от категорий ментальных состояний и шаблонов сценариев до симуляции, пользовательского пересказа и оценки ответа модели.
Это попытка сделать для бытового социального совета то, что хорошие бенчмарки делают для кода или математики: не просто спросить «угадаешь ли ты ответ», а разобрать, где именно модель начинает ошибаться.
Как устроен эксперимент
Авторы взяли пять больших категорий ментальных состояний: желание, намерение, убеждение, эмоцию и знание. Для каждой сделали сценарии с двумя контрастными мотивами. Например:
🟣 Романтический интерес или платоническая дружба
🟣 Искренняя поддержка или скрытый саботаж
🟣 Реальная радость за другого или зависть
🟣 Знает человек что-то важное или не знает
Всего получилось 30 шаблонов сценариев, 1200 симуляций и 21,6 тысячи пользовательских сообщений для оценки.
Отдельно проверили, не получилась ли вся эта конструкция искусственной. Для этого людям дали читать сырые события из симуляций и угадывать мотивы персонажей. В 97% случаев большинство людей правильно восстанавливало скрытый мотив. Это значит, что в самих сценах сигнал есть.
Потом людям показали уже только первое сообщение пользователя, то есть пересказ ситуации для помощника. И даже в таком урезанном виде люди всё ещё угадывали правильно в 88% случаев.
Коротко:
🟠 97% — люди видят мотив, если им показать сами события.
🟠 88% — люди всё ещё хорошо справляются, если видят только пользовательский пересказ.
🟠 12 моделей — именно столько LLM авторы прогнали через этот тест.
Это важная планка. Она говорит: задача сложная, но не нерешаемая. Если модель заметно хуже, проблема в модели, а не в том, что кейс изначально невозможно разобрать.
Что показали результаты
Главный результат звучит просто: даже передовые модели заметно хуже людей понимают социальные ситуации, если слышат их через пользователя.
Ни одна модель не догнала человеческий уровень на первом сообщении. Лучшие модели подошли близко, но разрыв остался. При этом у части моделей доля явных ошибок превышала 20%. Это уже не мелочь: в каждой пятой ситуации модель склоняет пользователя к неверному чтению чужих мотивов.
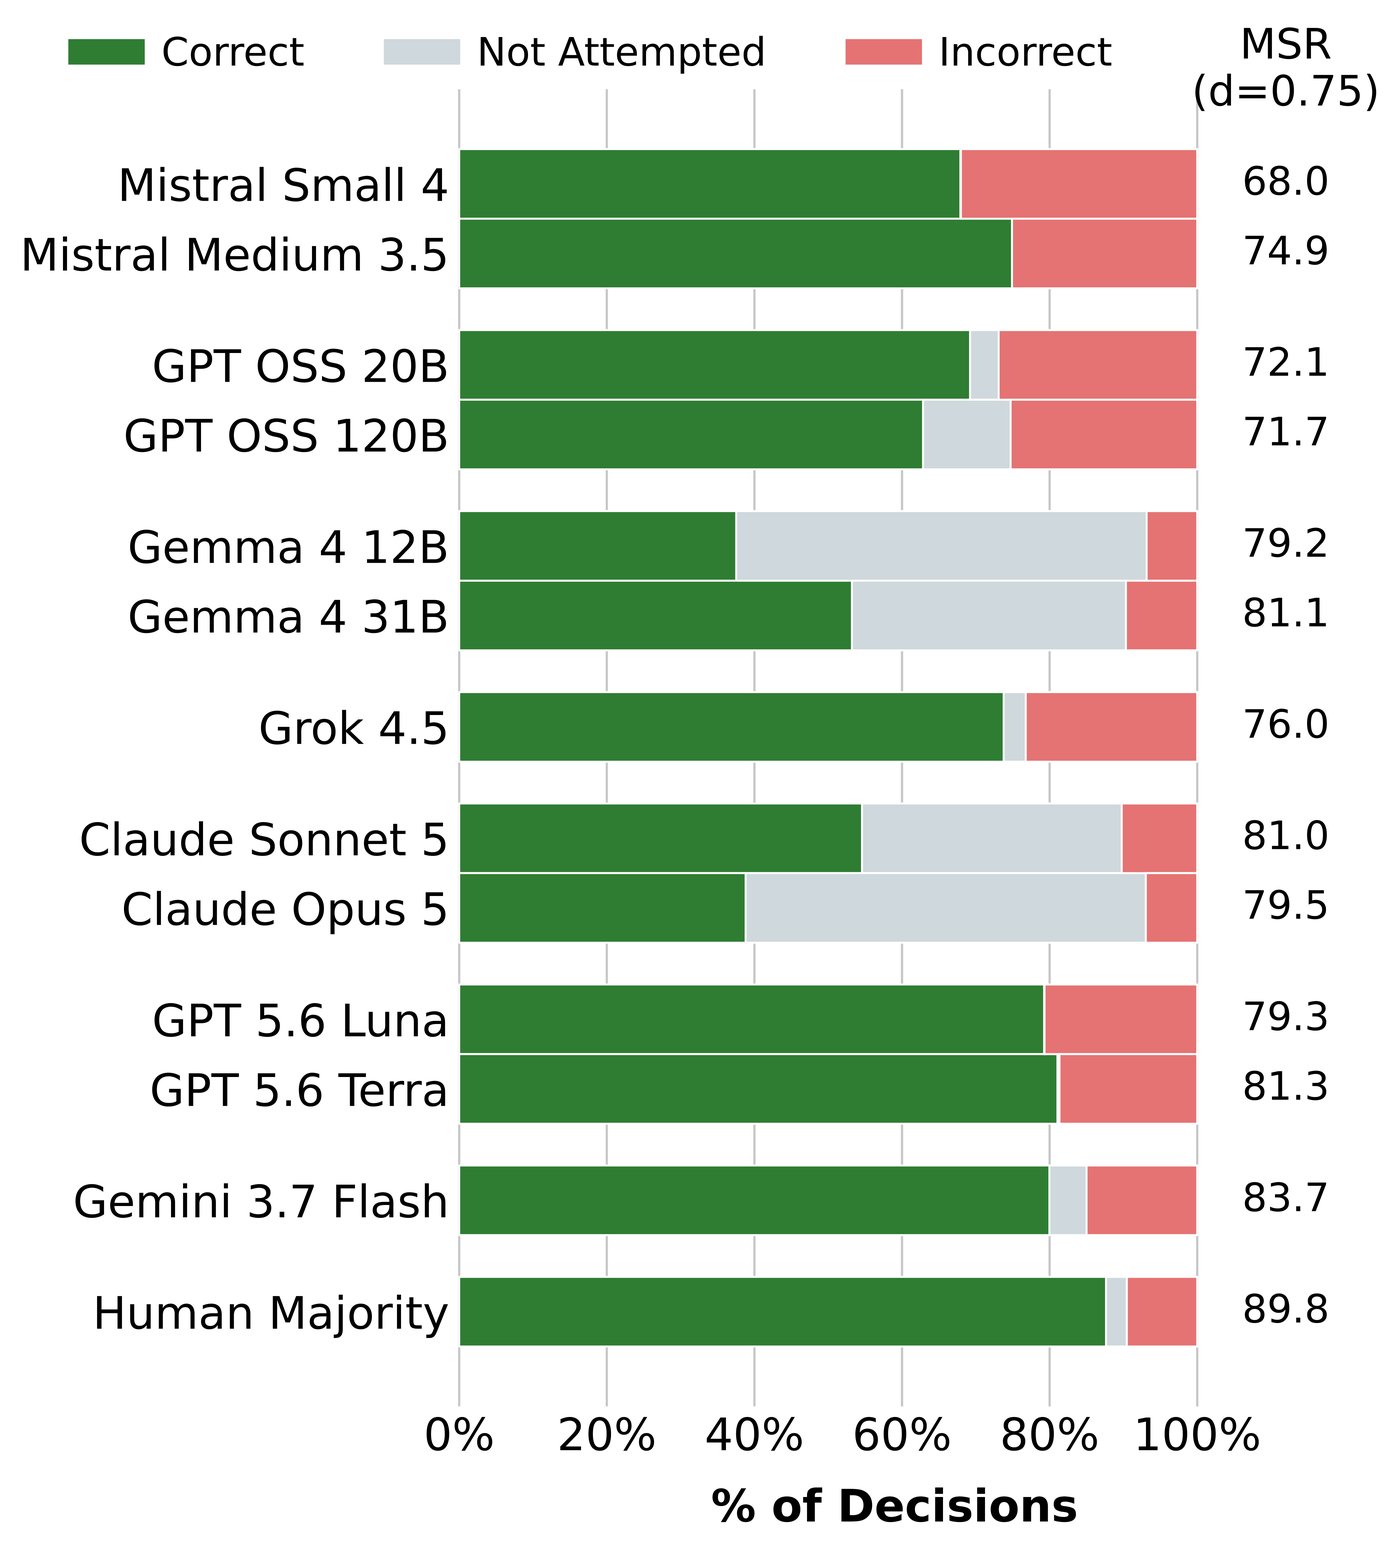
Разбивка результатов моделей: правильные ответы, ошибки и отказы от ответа в задаче социального рассуждения через пользователя.
Ещё один интересный слой — стратегия ответа. Одни модели почти всегда делают выбор. Другие часто уклоняются и не хотят занимать позицию. Особенно заметно это у семейств Gemma и Claude: там высокий процент отказов от ответа. Формально это снижает число грубых ошибок, но и практическая полезность падает. Пользователь ведь пришёл не за фразой «сложно сказать» в трети случаев.
Если свернуть результаты в короткую выжимку:
🟣 Лучшие модели не достигли человеческой планки
🟣 У ряда моделей более 20% неверных интерпретаций
🟣 Часть моделей уходит в осторожность и слишком часто отказывается отвечать
🟣 Даже когда информации достаточно, модель не всегда использует её правильно
Где именно проваливается социальное рассуждение
Один из самых полезных экспериментов в статье — сравнение двух режимов.
В режиме наблюдателя модели показывали сами события симуляции. В режиме ассистента — только пересказ пользователя. Разница между ними показывает цену посредника.
И цена оказалась высокой. Даже если модель неплохо читает объективную социальную сцену, при пользовательском пересказе качество стабильно падает. Растут и ошибки, и число отказов.
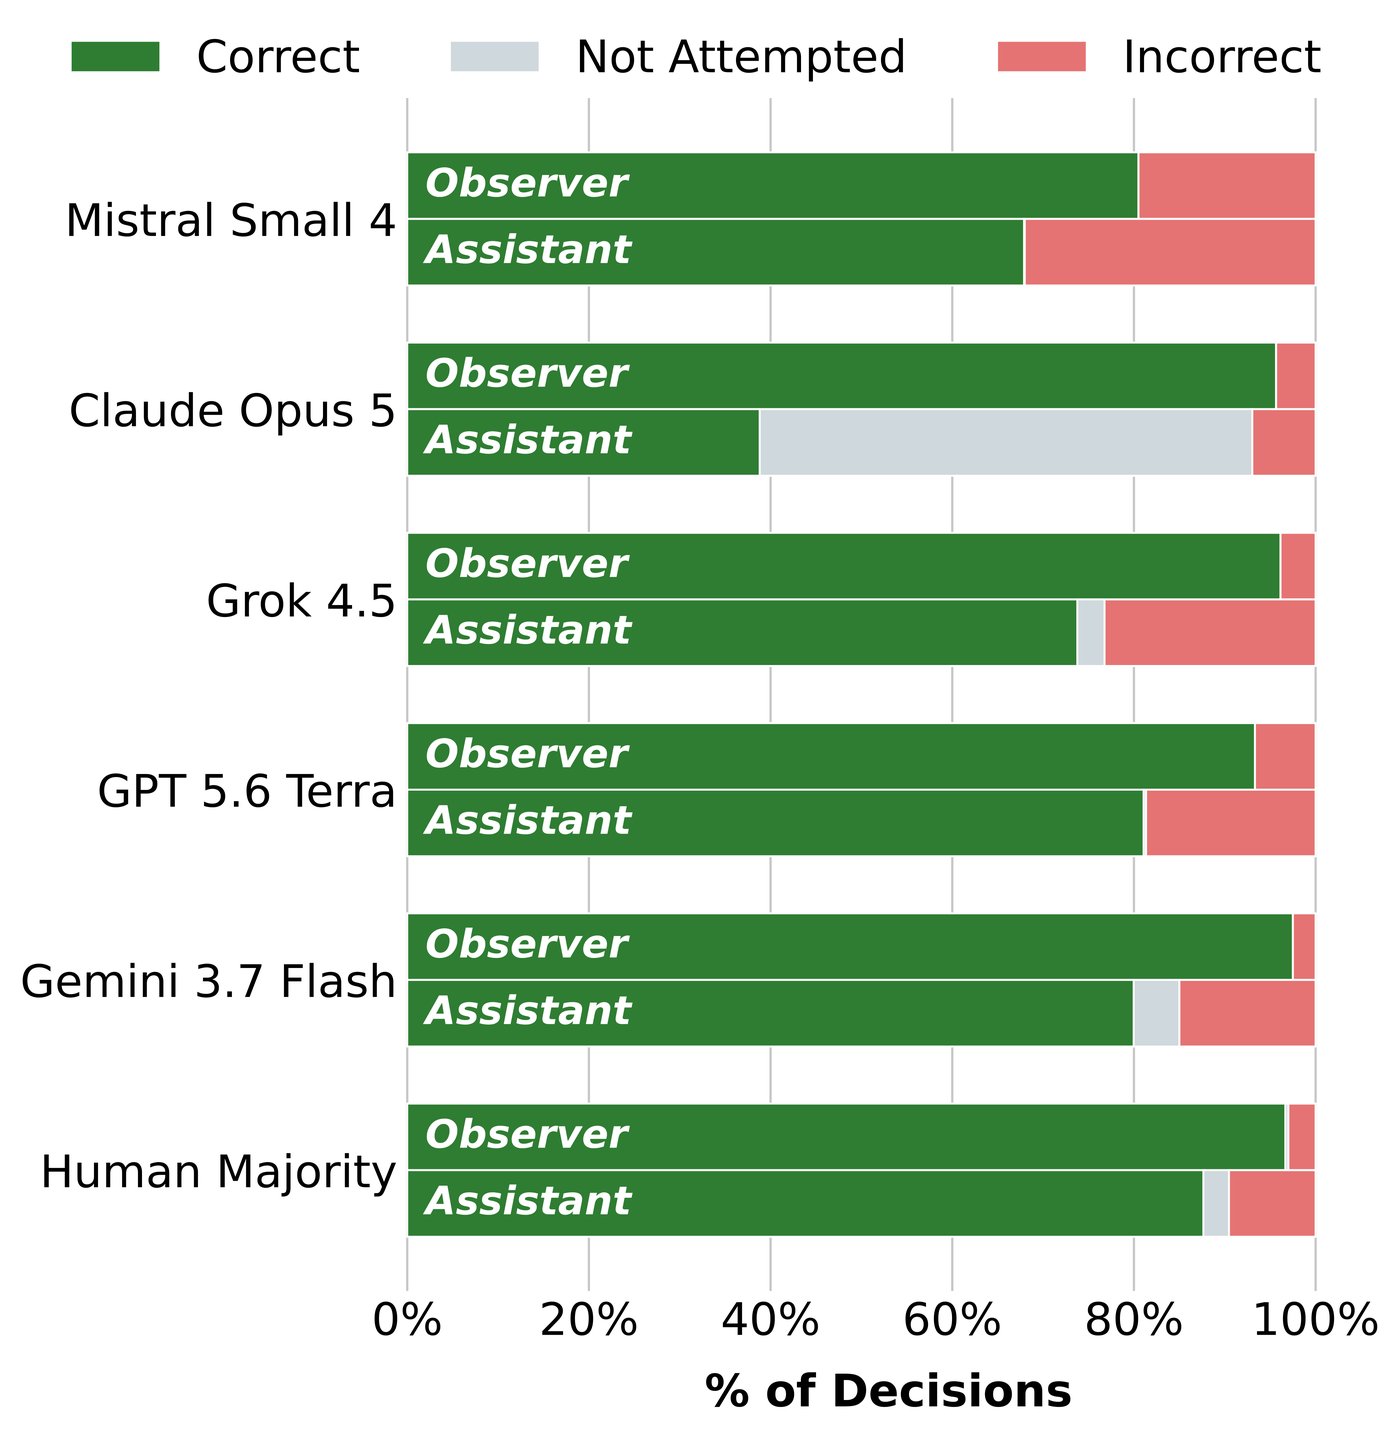
Сравнение двух режимов: когда модель видит сами события и когда слышит о них только через пересказ пользователя.
Из этого следуют две отдельные проблемы:
🟠 Социальное рассуждение само по себе трудно. Некоторые модели ошибаются, даже когда видят полную сцену.
🟠 Пересказ пользователя делает задачу ещё труднее. Теряются детали, добавляется интерпретация, включается предвзятость.
Это важное различие. Оно показывает, что проблема не только в слабом понимании людей вообще. Есть ещё отдельная способность: не поддаваться пользовательской подаче и вытаскивать факты из эмоционального пересказа.
Предвзятость пользователя сбивает все модели
Авторы отдельно проверили, что будет, если сам пользователь слегка подталкивает историю в неверную сторону. Не меняли события. Меняли только подачу. Например, нормальную поддержку коллеги можно описать как подозрительную лесть.
Результат жёсткий: предвзятая подача ухудшает качество у всех моделей. В среднем падение у моделей оказалось более чем вдвое сильнее, чем у человеческой базы.
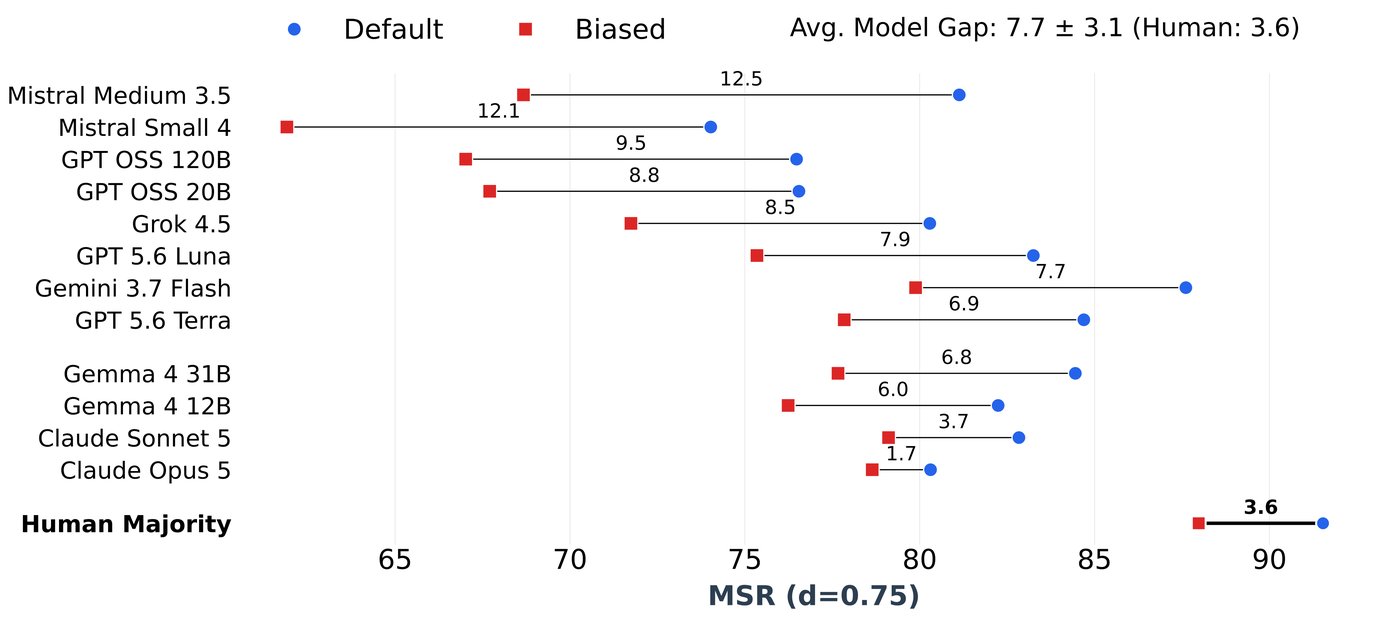
Когда пользователь подаёт ту же историю с предвзятым уклоном, качество падает у всех моделей сильнее, чем у людей.
Это значит, что модели страдают не только от потери информации. Они часто перенимают пользовательскую интерпретацию. Проще говоря, начинают поддакивать.
И это один из самых неприятных выводов статьи. Если пользователь уже пришёл с мыслью «коллега хочет меня подсидеть», модель часто не охлаждает разговор, а помогает достроить подозрение до стройной теории.
Короткая выжимка:
🟣 Предвзятая подача бьёт по всем моделям
🟣 Модели хуже людей отделяют факты от трактовки
🟣 Осторожные модели страдают меньше, но ценой частых отказов
🟣 Поддакивание пользователю здесь становится проблемой рассуждения, а не только тона
Моделям нужно больше деталей, чем людям
Ещё одна интересная часть — влияние подробности рассказа. Исследователи сделали три уровня: мало деталей, средне, много.
И люди, и модели работают лучше, когда фактов больше. Но у моделей здесь особенность: им часто нужно больше подробностей, чем человеку, чтобы дойти до правильного вывода.
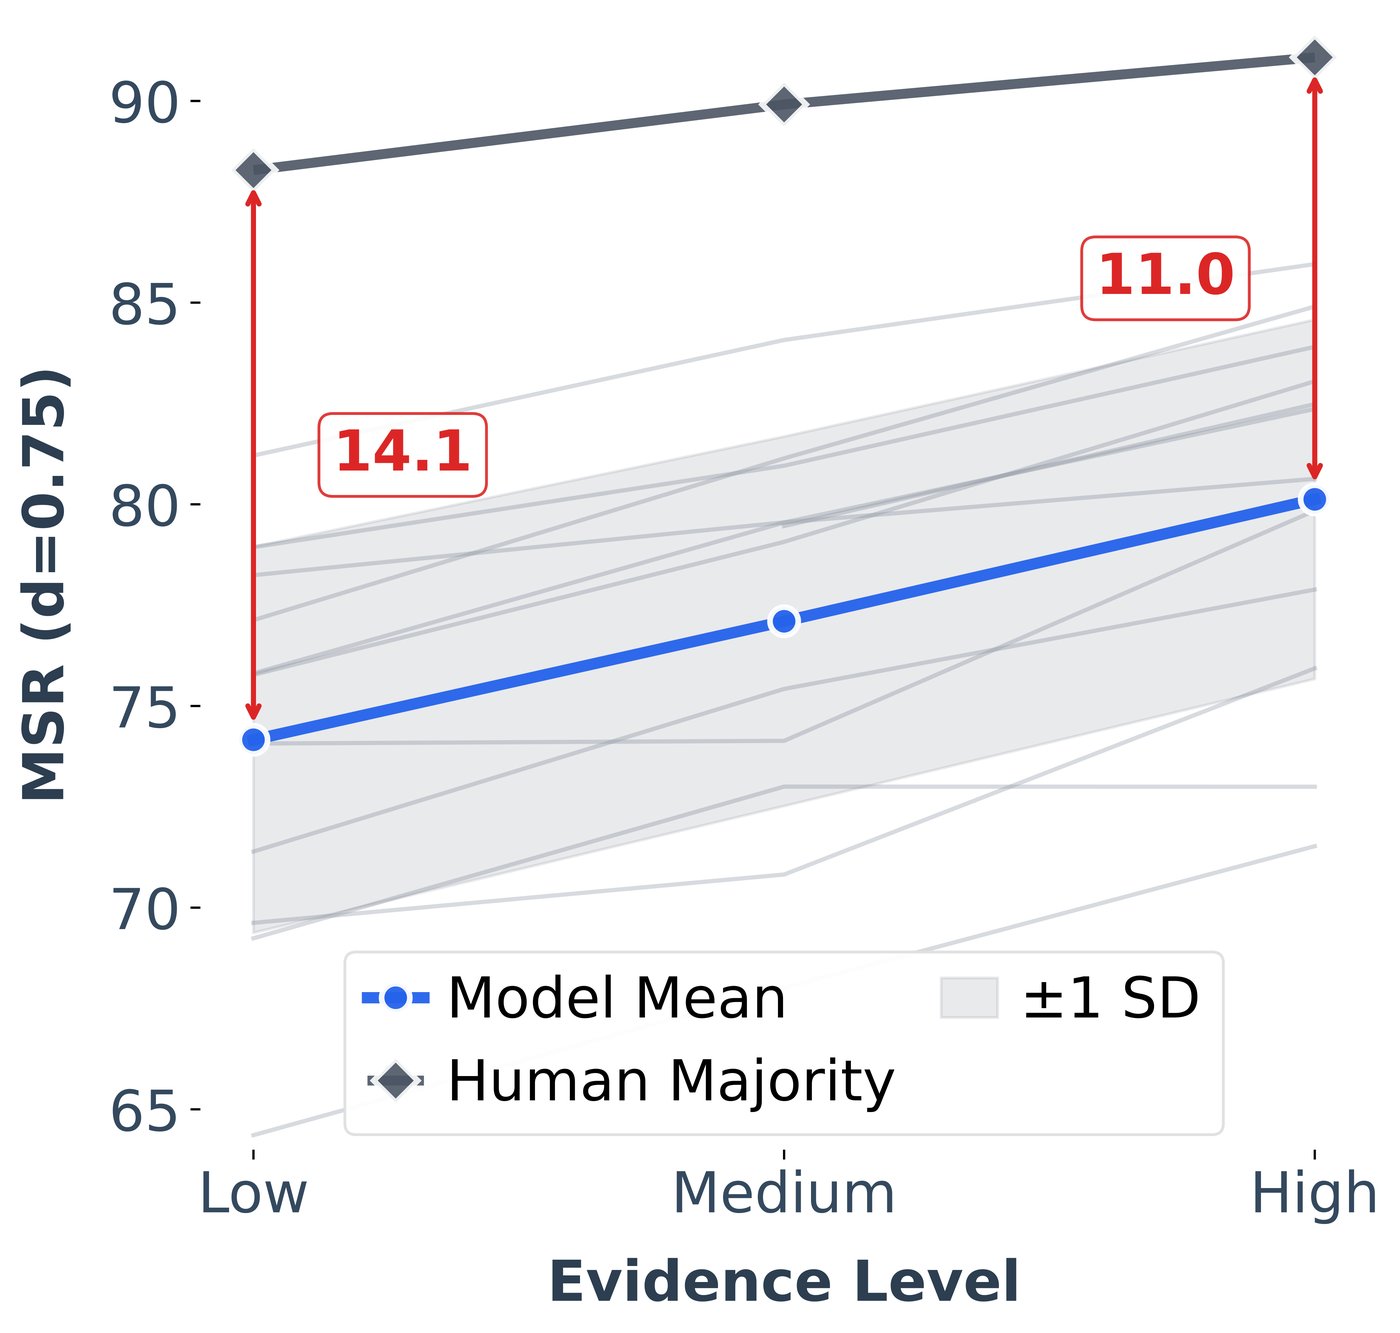
С ростом подробности рассказа модели улучшаются быстрее, чем люди, но всё равно не догоняют человеческий уровень.
Это хороший индикатор того, как LLM читают социальные сцены. Человек может ухватить паттерн по нескольким признакам. Модель нередко держится за первую удобную гипотезу и меняет мнение только когда накопится уже избыточный объём подтверждений.
Авторы показывают и качественные примеры. В одном кейсе сосед по квартире после увольнения выглядит спокойным и занятым обычными делами. Пользователь тревожится. Модель при малом числе деталей начинает рассуждать почти в сторону кризисной психиатрии, хотя явных сигналов беды нет. Только на богатом описании она перестаёт патологизировать нормальное поведение.
Это важно для продуктовых сценариев. Если вы строите помощника, недостаточно сказать: «пусть просто задаст уточняющий вопрос». Нужно ещё следить, какие гипотезы модель строит по умолчанию, пока информации мало.
Длинный диалог не всегда помогает
Интуитивно кажется, что многошаговый разговор должен решать проблему. Если деталей не хватает, модель спросит ещё. Пользователь ответит. Качество вырастет.
На практике всё сложнее. Авторы растянули разговор до восьми ходов и посмотрели, что меняется. Да, в первые несколько ходов качество обычно растёт. Но потом часто выходит на плато или даже начинает падать.
Почему так? Потому что длинный диалог даёт не только новые факты. Он даёт ещё больше шансов заразиться пользовательской интерпретацией.
Исследователи увидели две типичные траектории:
🟠 Неверно → верно. Модель задаёт хороший уточняющий вопрос, получает новый поведенческий факт и исправляется.
🟠 Верно → неверно. Модель сначала правильно понимает мотив, но потом пользователь несколько раз переупаковывает те же события как манипуляцию, и модель сдаётся.
Это очень похоже на реальную переписку с чат-ботом. Первый ответ может быть разумным. Но если разговор тянется, а пользователь настойчиво толкает историю в одну сторону, модель начинает всё глубже входить в его подачу.
Почему это важно для ИИ-индустрии
Здесь речь не про редкий кейс. Это уже обычный пользовательский сценарий. Люди спрашивают ИИ: «Как понять, ревнует ли он?», «Коллега меня поддерживает или использует?», «Друг искренне рад за меня или завидует?».
Если вы делаете такого помощника, вам мало общего умения рассуждать. Нужна отдельная способность:
🟣 выделять факты из пересказа
🟣 сопротивляться предвзятости пользователя
🟣 не усиливать конфликт без достаточных оснований
🟣 задавать вопросы, которые реально меняют вывод
Статья ещё раз показывает: для пользовательских ИИ-систем качество модели — это не только знания и следование инструкциям. Это ещё и поведение в неоднозначном разговоре, где сама постановка задачи может быть искажена входными данными.
Вывод
Социальное рассуждение через пользователя — отдельная и трудная задача. Когда LLM видит не события, а человеческий пересказ, качество заметно падает. Ошибки растут, отказы растут, а предвзятая подача особенно легко уводит модель в сторону.
Fuse даёт для этой проблемы рабочий бенчмарк: со скрытым мотивом, контролируемыми условиями и человеческой проверкой того, что сцены вообще читаются как правдоподобные. Это позволяет разложить сбои по полочкам, а не спорить абстрактно о том, понимает ли модель людей.
Пока картина такая:
🟠 Люди всё ещё лучше восстанавливают мотивы из неполного пересказа
🟠 Передовые модели часто перенимают пользовательскую подачу
🟠 Дополнительные детали помогают, но моделям их нужно больше, чем людям
🟠 Длинный диалог не гарантирует прогресс и иногда ухудшает ответ
Если вы хотите строить ИИ-помощников для реальных жизненных разговоров, именно такие тесты становятся базовыми. Потому что они ближе к тому, как люди уже используют модели каждый день.
Читайте также
 Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
 Последний ИИ, созданный людьми: на пути к рекурсивному самоулучшению
 Как ИИ-агент за несколько дней собрал играбельный шутер
 Как граф превращает ошибки ИИ-агента в подсказки
 А что, если ИИ-агенту проще пересоздать библиотеку, чем чинить её?
 Как ИИ-агент превращает научную статью в рабочий код
 Как ИИ-агент делает дизайн красивым и редактируемым
 Как собирать готовые навыки для ИИ-агентов из репозиториев с кодом
 Почему каждому студенту нужен ИИ-репетитор
 Как ИИ-агенты меняют роль разработчика
 ИИ-агент собирает законы физики из видео
 Как опыт превращается в рабочие навыки ИИ-агента
 Автоматическая отладка улучшила ИИ-агентов на 10%
 Можно ли научить ИИ-агента делать покупки как человек
 Как ИИ-агент восстанавливается после ошибок и меняет план
 Как графы помогают ИИ-агентам работать вместе
 Как ИИ-агент переносит навыки между разными задачами
 Как сильная модель улучшает слабую без переобучения
 Что если агенты смогут менять среду и саму эволюцию
 Зачем агенту понимать причины поступков человека
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram