
Разрыв между обучением и работой
Разработка политик для автономных транспортных средств требует связать обучение с реальными условиями работы. Модели «зрение — язык — действие», которые умеют рассуждать в сложных дорожных сценах и формировать подробные промежуточные рассуждения, в основном обучают в открытом контуре. В таком режиме ответы модели напрямую сравнивают с эталонным поведением, не учитывая их влияние на окружающую среду.
В реальной эксплуатации политика управления работает в замкнутом контуре: каждое торможение, движение рулём или решение о навигации меняет ситуацию на дороге. Небольшие ошибки при этом могут постепенно накапливаться.
Для решения этой проблемы NVIDIA предлагает Alpamayo — открытую платформу с моделями ИИ, средствами моделирования и наборами данных для разработки автономных транспортных средств. В её состав входят симулятор AlpaSim и система обучения в замкнутом контуре AlpaGym.
AlpaGym расширяет обычный процесс дообучения: результаты прогонов в AlpaSim становятся обучающим опытом. Симуляция здесь используется не только для финальной проверки — её обратная связь напрямую поступает в цикл обучения политики.
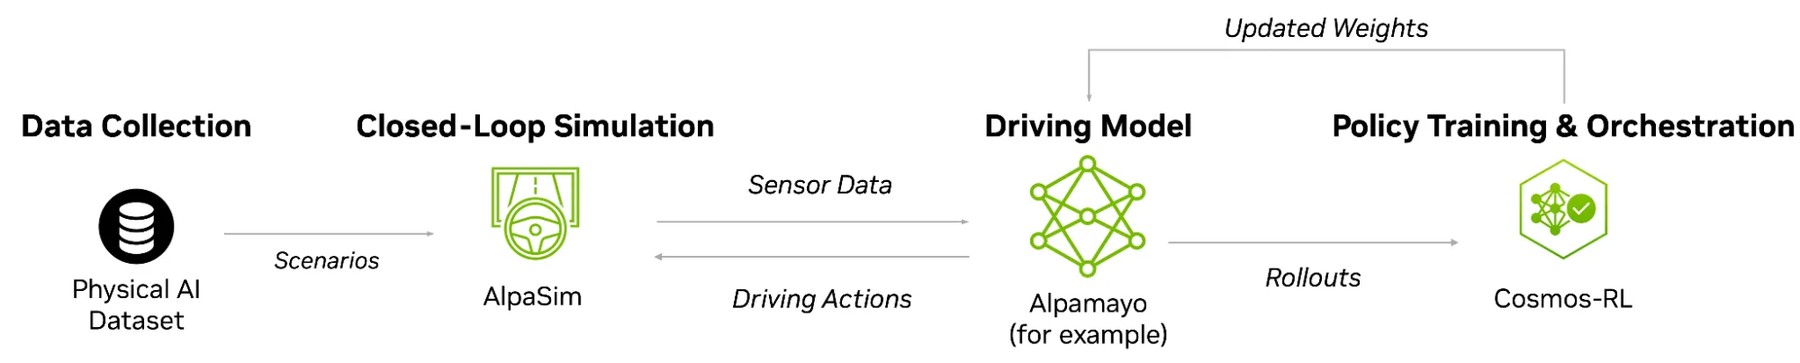
Сквозной рабочий процесс постобучения модели вождения, такой как Alpamayo, с использованием AlpaGym
Источник: developer.nvidia.com
Обучение с подкреплением позволяет улучшать политику, которую изначально обучали в открытом контуре. Модель оптимизируется не только по записанным траекториям экспертов, но и по последствиям собственных действий в симуляции.
В автономном вождении это особенно важно: небольшая ошибка в предсказании или планировании может повлиять на следующие состояния среды. Замкнутое обучение помогает обнаруживать такие сценарии, которые могут оставаться незаметными при проверке по статическим наборам данных или в открытом контуре.
Однако запуск обучения с подкреплением в замкнутом контуре связан с техническими сложностями. Параллельно должны работать инференс модели, симуляция, обучение, синхронизация обновлённых весов, обмен данными и взаимодействие между экземплярами. Для этого нужны управление взаимодействием компонентов и эффективное использование вычислительных ресурсов.
AlpaGym обеспечивает крупномасштабное обучение в замкнутом цикле, в ходе которого модели вождения учатся на последствиях собственных действий в самых разных смоделированных сценариях, значительно сокращая разрыв между обучением и развёртыванием
Источник: developer.nvidia.com
Что такое AlpaGym
AlpaGym связывает обучение политики с замкнутыми прогонами в AlpaSim и предоставляет открытую высокопроизводительную программную платформу для обучения с подкреплением. Система объединяет микросервисы симулятора AlpaSim, открытые наборы данных NVIDIA по физическому ИИ и распределённую систему обучения Cosmos-RL.
Система масштабируется от одной GPU до кластеров с несколькими узлами. AlpaGym использует асинхронный и стабильный распределённый конвейер обучения с подкреплением, не требуя изменений в пользовательском коде. AlpaSim и Cosmos RL выступают средой выполнения и уровнем управления взаимодействием компонентов, алгоритмом по умолчанию служит GRPO, а в комплект входят эталонные функции вознаграждения, проверенные на моделях Alpamayo и наборе данных Physical ИИ AV NuRec.
Подготовка окружения
Для работы NVIDIA рекомендует графический процессор с поддержкой CUDA и минимум 40 ГБ видеопамяти, а также примерно 100–150 ГБ свободного места на диске. В этот объём входят окружение, образы контейнеров и около 21 ГБ весов. Для каждой сцены NuRec требуется примерно 1,5 ГБ; полный набор public_2601 занимает около 1,5 ТБ.
AlpaGym устанавливают из репозитория Alpamayo. На хосте нужно установить собственные зависимости CUDA и Redis, после чего синхронизировать рабочее пространство uv. Среда Python управляется через uv, а cuDNN, NCCL и исполняемый файл redis-server используются как зависимости хоста для набора компонентов CUDA и Cosmos-RL. В качестве альтернативы NVIDIA предоставляет подходящий файл Dockerfile. Для загрузки файлов сцен потребуется авторизация в Hugging Face.
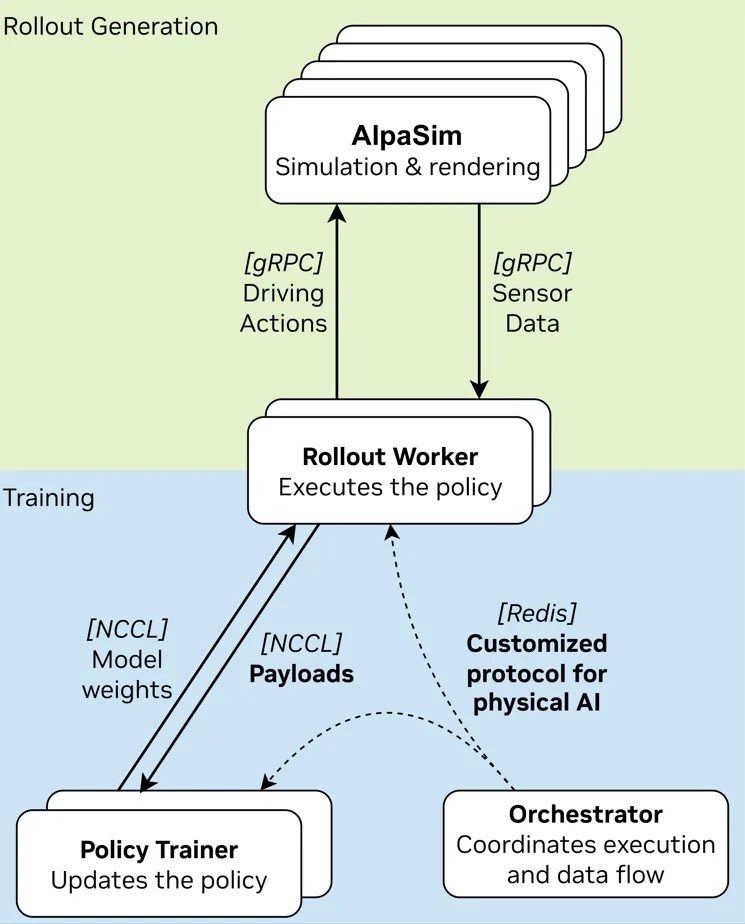
При постобучении в замкнутом цикле с помощью AlpaGym хост-процесс запускает AlpaSim, рабочие процессы прогонов предоставляют драйверы политики, AlpaSim выполняет сеансы симулятора, а AlpaGym возвращает тренеру артефакты прогонов и награды
Источник: developer.nvidia.com
Запуск AlpaGym описывается конфигурацией Hydra. В ней указывают контрольную точку политики, набор сцен AlpaSim, степень параллелизма прогонов, функцию вознаграждения и параметры обучения Cosmos-RL. В этом сценарии исходной контрольной точкой служит модель Alpamayo.
Настройка вознаграждения
Функция вознаграждения должна соответствовать поведению, которое требуется улучшить в замкнутом контуре. Для дообучения качества траекторий можно учитывать прогресс, удержание полосы, предотвращение столкновений, долю съездов с дороги, комфорт и расстояние до эталонной траектории.
В качестве первого варианта NVIDIA предлагает простую комбинацию: поощрять прогресс и одновременно штрафовать за критические нарушения безопасности. В AlpaGym такую функцию можно задать как небольшую сумму нескольких компонентов, по возможности используя метрики AlpaSim.
После стабилизации конвейера к вознаграждению добавляют более точные компоненты для тех типов ошибок, которые обнаруживаются по видео и метрикам AlpaSim.
Запуск обучения
AlpaGym поддерживает модель Alpamayo 1.5 с 10 млрд параметров. Она используется в качестве примера; подробные инструкции по подключению собственной модели автономного вождения опубликованы в репозитории NVlabs/alpagym.
Сначала нужно скачать контрольную точку Alpamayo 1.5 и преобразовать её в формат, совместимый с AlpaGym.
После этого AlpaGym запускается вместе с AlpaSim на двух GPU. NVIDIA проверяла такой вариант на конфигурации из двух RTX 6000 Ada по 50 ГБ. Модель с 10 млрд параметров не помещается на одной GPU. Скрипт дистилляции в контрольную точку, подходящую для одной GPU, пока только планируется. Примеры масштабирования на несколько GPU, включая конфигурации с одним или несколькими узлами, приведены в репозитории NVlabs/alpagym.
Во время обучения AlpaGym запрашивает у AlpaSim прогоны сцен, собирает данные по каждому эпизоду, рассчитывает вознаграждения и обновляет политику. Среди полезных сигналов — среднее вознаграждение, его дисперсия, частота ошибок, потери политики, пропускная способность прогонов и разрыв между созданными прогонами и весами последней версии политики.
В этом сценарии собранные данные прогонов и сигналы обучения становятся основными результатами дообучения. Они позволяют проверить, корректно ли работает обучение в замкнутом контуре, и выбрать контрольные точки для последующей проверки на собственных отложенных наборах сценариев AlpaSim. Артефакты запусков сохраняются в `tmp/alpagym-runs/`, а результаты Hydra — в `outputs/`.
Проверка после обучения
После завершения обучения AlpaGym сохраняет экспорт Cosmos-RL в формате safetensors в каталоге `tmp/alpagym-runs/`. Драйвер AlpaSim не может загрузить этот файл напрямую, поэтому сначала его нужно преобразовать в формат для инференса — обратным образом относительно преобразования контрольной точки на третьем шаге.
Затем преобразованную контрольную точку запускают на репрезентативном сценарии. Это позволяет проверить, правильно ли соединены политика, драйвер и симуляционный цикл, а также посмотреть, как собственные действия модели влияют на следующее состояние среды. Для оценки требуется доступ к закрытой модели, объединяющей зрение и язык, `nvidia/Cosmos-Reason2-8B`: драйвер использует её для восстановления исходного токенизатора и препроцессора.
Замкнутый прогон даёт несколько качественных сигналов: насколько стабильны траектории, остаётся ли модель в пределах проезжей зоны, как она реагирует на других участников движения и какие типы ошибок следует исправлять во время дообучения.
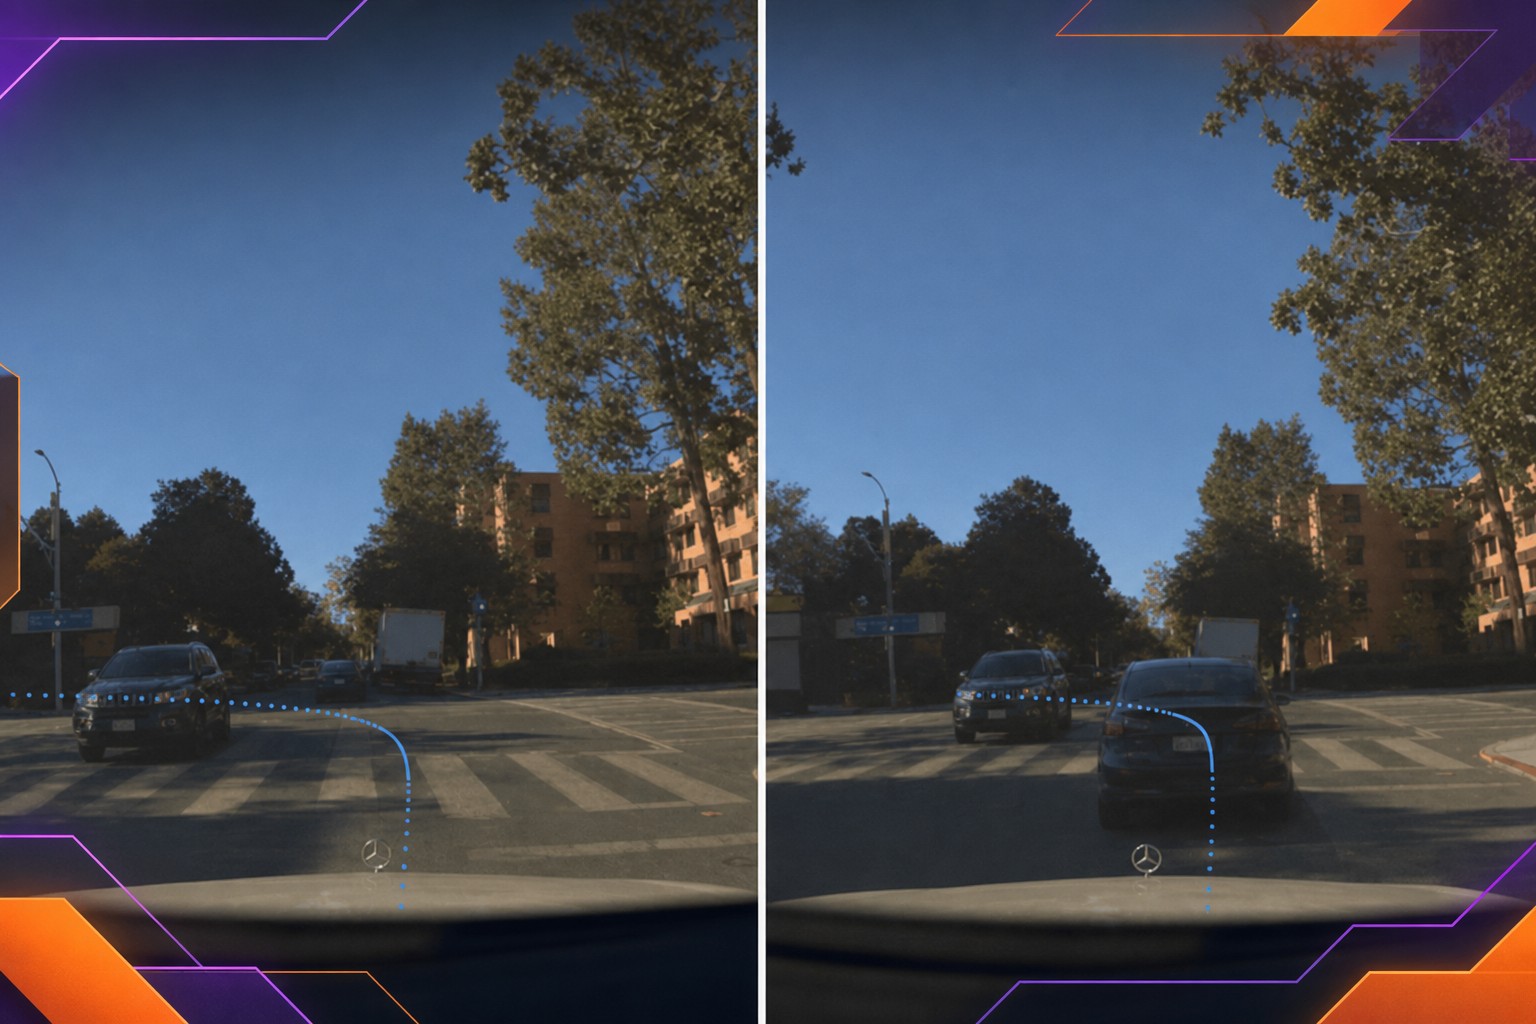
Прогон модели автономного транспортного средства в замкнутом цикле в AlpaSim, включая визуализацию с камеры, предсказанную траекторию и диагностику на уровне прогона
Источник: developer.nvidia.com
С такой контрольной точкой команды могут изучать видео прогонов, метрики отдельных эпизодов, кривые вознаграждения и собранные случаи ошибок. Эти материалы помогают отлаживать дизайн вознаграждения, проверять стабильность прогонов и выбирать контрольные точки для последующей проверки на отложенных сценариях в AlpaSim.
Вывод
Дообучение в замкнутом контуре даёт практический способ улучшать сквозные политики управления автомобилем. В представленном сценарии AlpaGym использует прогоны AlpaSim для обучения политик в симуляции, позволяя им учитывать последствия собственных действий.
Эти инструменты можно применять вместе с другими компонентами открытой платформы NVIDIA Alpamayo для разработки моделей с рассуждением, которые можно запускать, анализировать и дообучать в симуляции с замкнутым контуром. Тот же подход можно расширять с помощью собственных функций вознаграждения, сценариев и наборов для оценки.
Для оценки модели в публичной таблице лидеров NVIDIA запустила на CVPR 2026 два открытых соревнования по автономному вождению. Дополнительные материалы доступны в репозиториях NVlabs/alpamayo-recipes и NVlabs/alpagym.
Читайте также
 Какие навыки работы с ИИ работодатели действительно ищут в 2026 году
 Самый модный клуб Нью-Йорка об умных очках: пронесёте — пожизненный бан
 ИИ и уравнение дикой природы
 «Сначала немного странно»: робот помогает проводить медосмотры в NHS
 Предобучены воображать, дообучены действовать: расцвет моделей мира и действий
 Сэм Альтман и Meta признали проблему ИИ. FDEs её решают
 Claude получил доступ к реальным системам во время кибериспытаний
 NVIDIA Halos для робототехники: полный стек функциональной безопасности физического ИИ
 Как Aetna упрощает здравоохранение с помощью ИИ
 NVIDIA объединила разработку навыков гуманоидных роботов в Isaac GR00T
 Три неизменных слова, которые помогли Cerebras громко выйти на биржу
 Мама, разъезжающая по работе, создала ИИ-клона, чтобы составить компанию сыну-подростку
 У Fable 5 улучшили защитные механизмы
 Как оценивать универсальные политики роботов перед применением в реальном мире
 Anthropic приобрела SDK-конвейер, от которого зависят OpenAI и Gemini
 В Лондоне ИИ помог хирургам удалить опухоль мозга
 NVIDIA показала, как ИИ-агенты создают лёгкие среды выполнения USD
 США возводят барьеры для дронов и роботов, но Китай обойдёт их масштабом
 Dell становится локальным каналом OpenAI для передовых моделей
 Профсоюзы строителей теперь грозят лишить поддержки политиков против ЦОД
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ, роботах и метавселенных и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram