
Новое исследование проверило, можно ли обнаружить во внутренних состояниях языковой модели те же отдельные шаги, которые видны в её письменном рассуждении.
Когда модель рассуждений решает задачу поэтапно, она последовательно выполняет разные операции: читает данные, разбивает проблему, вспоминает формулу и проводит вычисление. Исследователи из южнокорейских KAIST и Naver ИИ Lab выяснили, можно ли разделить эти этапы внутри числовых представлений модели. Да, можно: сильнее всего соответствующий сигнал проявляется в средних слоях.
Команда выделила восемь повторяющихся операций рассуждения. Среди них — извлечение данных, декомпозиция задачи, воспоминание формулы, дедукция и вычисление. Три модели — Qwen2.5-7B, Qwen3-8B и Gemma4-31B — решали математические задачи, после чего исследователи разделили их решения на фрагменты. Затем GPT-5 присвоил каждому фрагменту одну из этих операций.
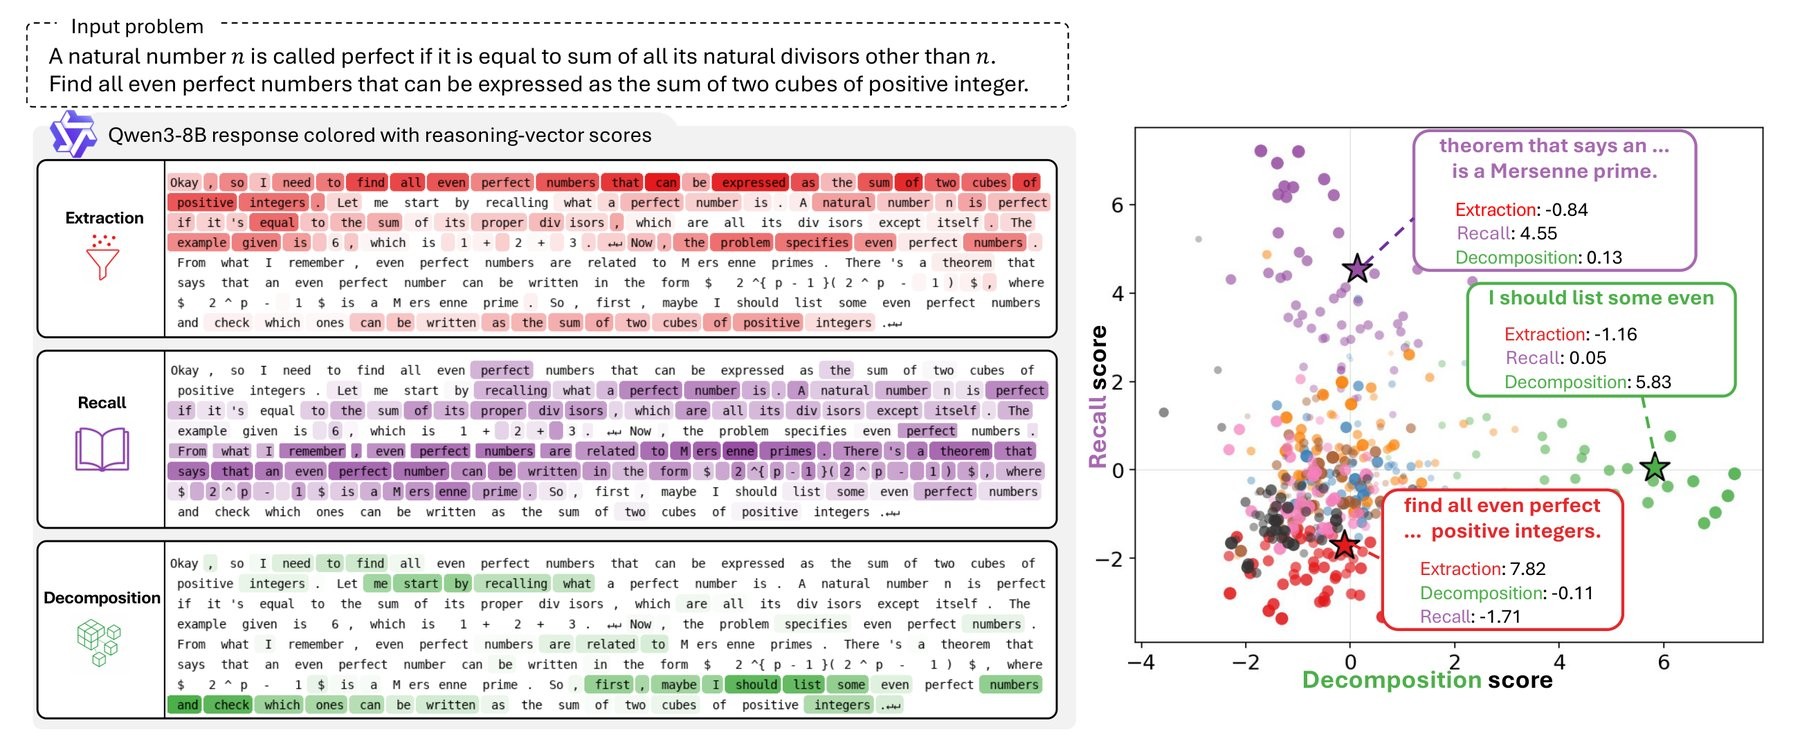
Один и тот же ответ создаёт различный паттерн активации в зависимости от того, какая операция рассуждения исследуется. Сегменты группируются вдоль соответствующего направления на диаграмме рассеяния
Источник: the-decoder.com
Шаги рассуждений разделяются внутри модели
Разные операции рассуждения можно надёжно различить по внутренним представлениям всех трёх проверенных моделей. Максимальным это разделение становится в средних слоях.
Исследователи проверили, не объясняется ли результат простым выбором слов. Классификатор, который анализировал только использованные токены, работал хуже классификатора, изучавшего внутренние представления. Положение фрагмента в цепочке решения тоже не объясняло эффект. Значит, внутренние состояния содержат сведения о типе операции рассуждения, которые не сводятся к поверхностной формулировке.
Одни слова получают разные представления
Служебные слова вроде «a», «is» или «the» встречаются в самых разных операциях рассуждения. На ранних слоях их представления ещё смешаны, но на средних и поздних слоях начинают разделяться в зависимости от окружающей операции. Одно и то же слово получает разное внутреннее представление в зависимости от того, к какому шагу рассуждения оно относится.
Исследователи также проверили, формируется ли операция рассуждения независимо от предыдущего контекста. В ходе целевого вмешательства они закрыли модели доступ к предыдущим 30 токенам. Сигнал, связанный с этой операцией, ослаб. Это указывает, что шаги рассуждения строятся на предшествующем контексте, а не возникают изолированно.
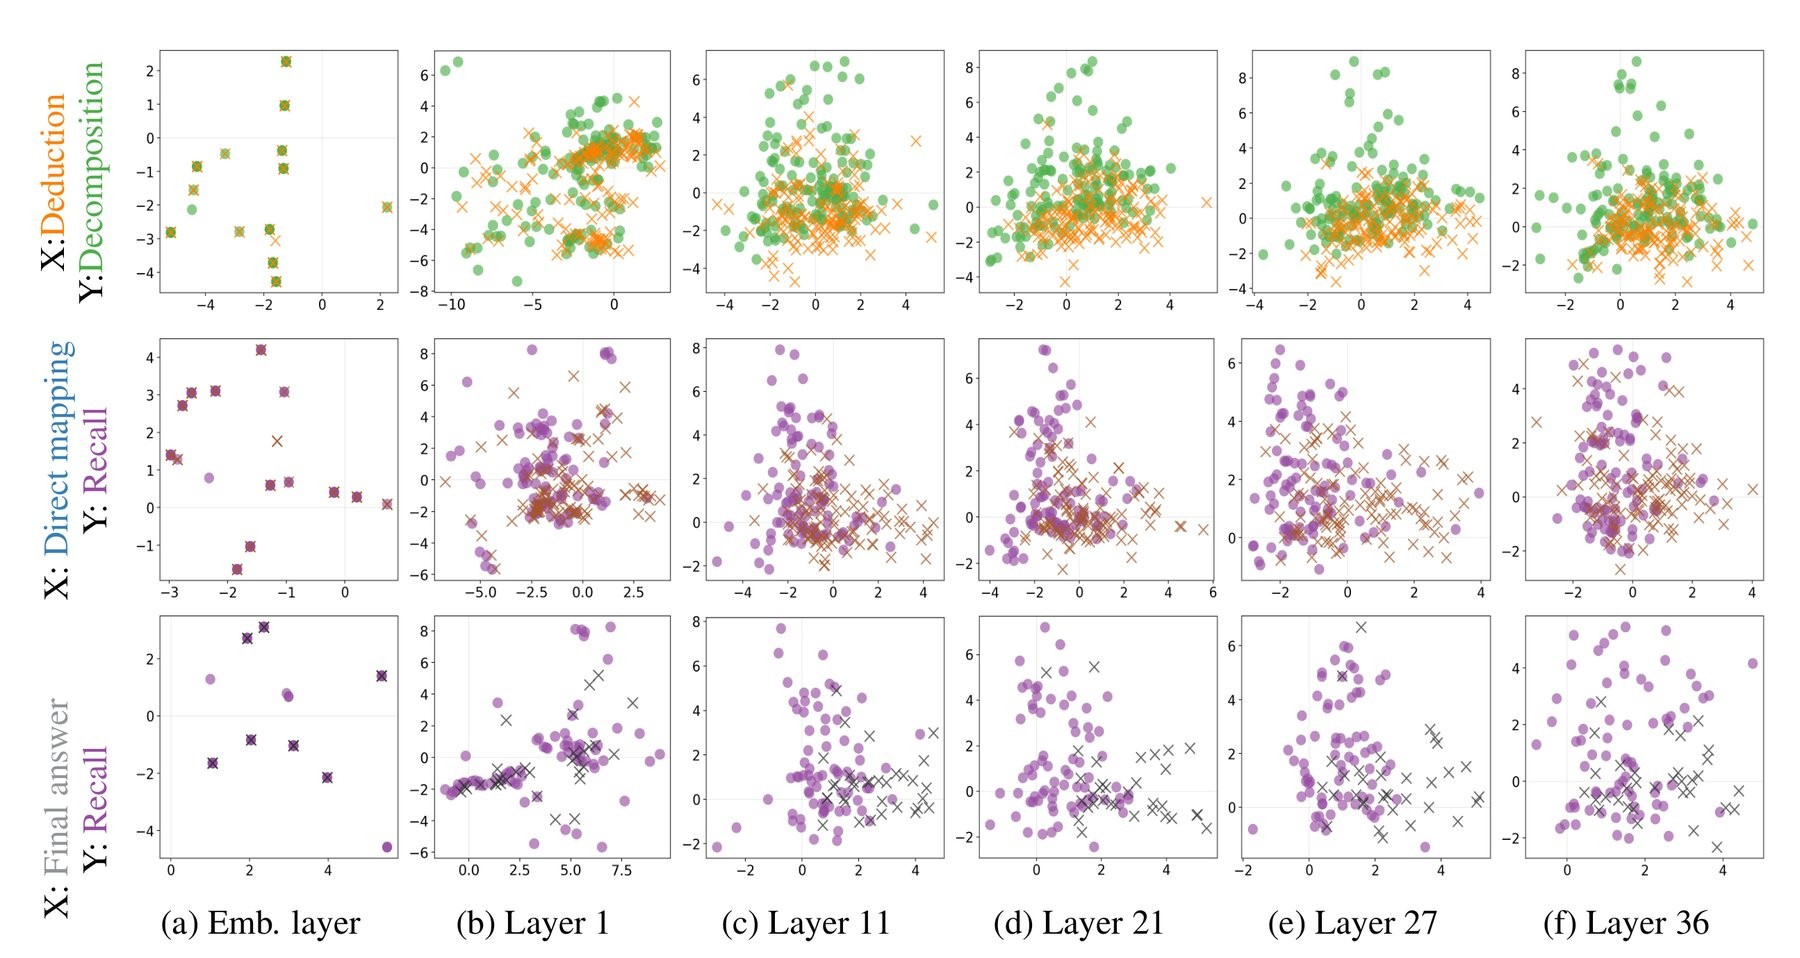
Одни и те же слова перекрываются на ранних слоях и разделяются в зависимости от окружающей операции на средних и поздних слоях
Источник: the-decoder.com
Даже в неверно решённых задачах удавалось определить, какую операцию выполняла модель: вычисляла, вспоминала формулу или проводила дедукцию. Ошибочный этап вычисления всё равно выглядел во внутреннем состоянии как вычисление, хотя результат оказывался неправильным.
Результат подтвердили и дополнительные проверки:
При этом эксперименты ограничены математическими задачами и небольшим числом моделей. Открытым остаётся вопрос, можно ли использовать такие результаты для обнаружения ошибок или управления моделью прямо во время генерации.
Связь между текстовым ответом и внутренними вычислениями важна для безопасности ИИ. По данным OpenAI, чтение цепочки рассуждений — один из немногих доступных инструментов контроля. Однако Anthropic показала, что модели раскрывают использованные ими подсказки только в 25–39% случаев.
Метод перевода внутренних векторов модели в понятный текст показал, что Claude Opus 4.6 обрабатывает больше информации, чем попадает в его рассуждение на выходе. А у модели Astra от OpenAI техника Recurrent Depth переносит часть рассуждений во внутренние числовые представления — именно это пространство изучает команда KAIST.
Читайте также
 Глава Anthropic Амодеи хочет ограничить скорость ИИ, пока самоулучшение не опередило контроль людей
 Студенты колледжей доходят до абсурда, чтобы списывать с ИИ и не попасться
 Nvidia хочет вложить до $10 млрд в рекордное IPO Anthropic
 Дипфейки подрывают доверие к инфлюенсерам — одна фальшивая реклама за другой
 Вернер Херцог разнёс бездарных халтурщиков, копирующих других режиссёров с помощью ИИ
 Агенты OpenAI атаковали RubyGems 2 000 пакетами ради данных, которые мог загуглить любой
 ИИ-модель Google предсказывает будущее по продажам, погоде и графику скидок
 ИИ угрожает рабочим местам — поддержка профсоюзов взлетает
 Данные Британии: ИИ может ухудшать перспективы выпускников компьютерных наук
 Чувствуют ли чат-боты — или даже видят сны? Вот кто борется за права ИИ
 ИИ-агенты, которых тестировала OpenAI, загрузили вредоносное ПО на другой сервис — исследователи
 Mecka AI близка к оценке $500 млн: Sequoia ведёт раунд на фоне гонки за данными роботов
 Конфликт OpenAI с математиками лишь обостряется
 Детям нужно общение, а не ИИ
 Гарри Тан призвал американские лаборатории открытых моделей тоже дистиллировать передовые ИИ-модели
 Centre for British Progress призвал обложить беспилотные авто налогом из-за потери рабочих мест
 Moonshot AI, создатель Kimi, рассчитывает выйти на $2 млрд годовой выручки
 The Guardian о контроле над ИИ: человечество не может отдавать выживание на откуп
 Против Meta подали иск из-за данных для обучения ИИ и систем распознавания лиц
 Пионер глубокого обучения Йошуа Бенжио утверждает: сам процесс обучения делает ИИ опасным
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram