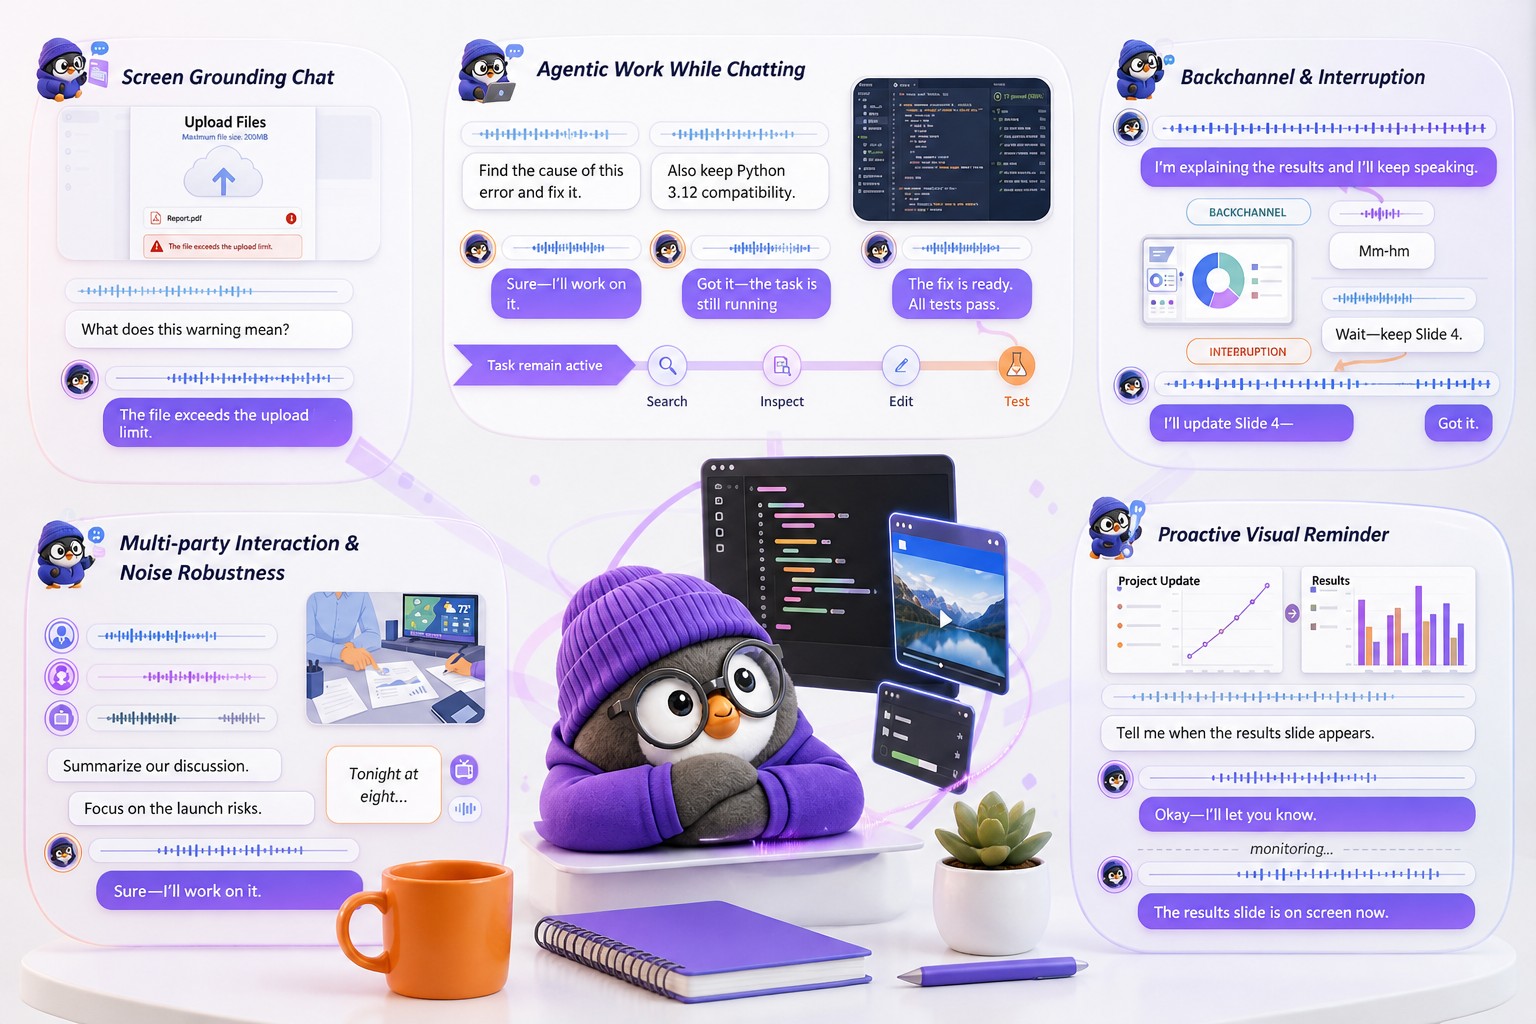
Gander от Tencent стремится не замолкать, работая в фоне
Tencent представила исследовательскую модель Gander, которая одновременно разговаривает с пользователем и выполняет сложные задачи в фоне. Модель обрабатывает речь, изображения и текст, может слушать и говорить одновременно, принимать перебивания в любой момент, задавать уточняющие вопросы и сообщать о ходе работы. В архитектуре Gander разговором управляет быстрый «мозжечок», а отдельный «мозг» решает более сложные задачи. На тестах модель реже перебивала пользователей, чем конкуренты, но уступила им по точности выполнения задач и показала слабые результаты в понимании видео и аудио. Tencent планирует открыть веса и данные обучения, а код уже доступен на GitHub.